
Hub documentation
Bacs de stockage
Bacs de stockage
Les Storage Buckets sont un type de dépôt sur le Hugging Face Hub offrant un stockage d’objets de type S3, propulsé par le backend de stockage Xet. Contrairement aux dépôts basés sur Git (modèles, jeux de données, Spaces), les buckets sont non versionnés et mutables, conçus pour des cas d’usage nécessitant un stockage simple et rapide, tels que les points de contrôle d’entraînement, les journaux, les artefacts intermédiaires ou tout grand ensemble de fichiers qui ne nécessite pas de contrôle de version.
Vous pouvez interagir avec les buckets via l'interface web du Hub, le hf CLI ou l'API Python.
Les buckets sont disponibles pour tous les utilisateurs et toutes les organisations. Consultez hf.co/storage pour les détails sur la tarification.
Consultez Access Patterns pour savoir comment accéder aux données du bucket depuis vos outils (montage en système de fichiers, chemins
hf://, montages de volumes dans Jobs/Spaces), l'S3-Compatible API pour utiliser les outils S3 existants (AWS CLI, boto3, s5cmd), et Bucket Integrations pour des extraits de code prêts à l'emploi dans des bibliothèques de données populaires comme pandas, Dask et Spark.
Buckets vs dépôts
Le Hub propose deux types de stockage : des dépôts basés sur Git pour un travail collaboratif versionné et des buckets pour un stockage d'objets mutable et rapide.
| Fonctionnalité | Dépôts (basés sur Git) | Bacs de stockage |
|---|---|---|
| Gestion des versions | Historique Git complet | Aucun (mutable, modification en place) |
| Types | Modèles, Jeux de données, Espaces | Seau autonome |
| Cas d'usage principal | Publication des artefacts finalisés | Stockage de travail / données intermédiaires |
| Opérations | API du Hub, Git push/pull | Synchronisation sync, cp, rm de type S3 |
| Déduplication | Xet au niveau des blocs | Xet au niveau des blocs |
| Pull Requests | Oui | Non |
| Cartes de modèle/de jeu de données | Oui | Non (mais le README brut est rendu) |
Utilisez les dépôts lorsque vous souhaitez un historique des versions, des fonctionnalités de collaboration (PR, discussions) et des intégrations de bibliothèques. Utilisez les bacs lorsque vous avez besoin d’un stockage rapide et mutable pour des données qui changent fréquemment — les fichiers peuvent être écrasés ou supprimés sur place.
Créer un Bucket
Depuis l'interface du Hub
- Accédez à huggingface.co/new-bucket :
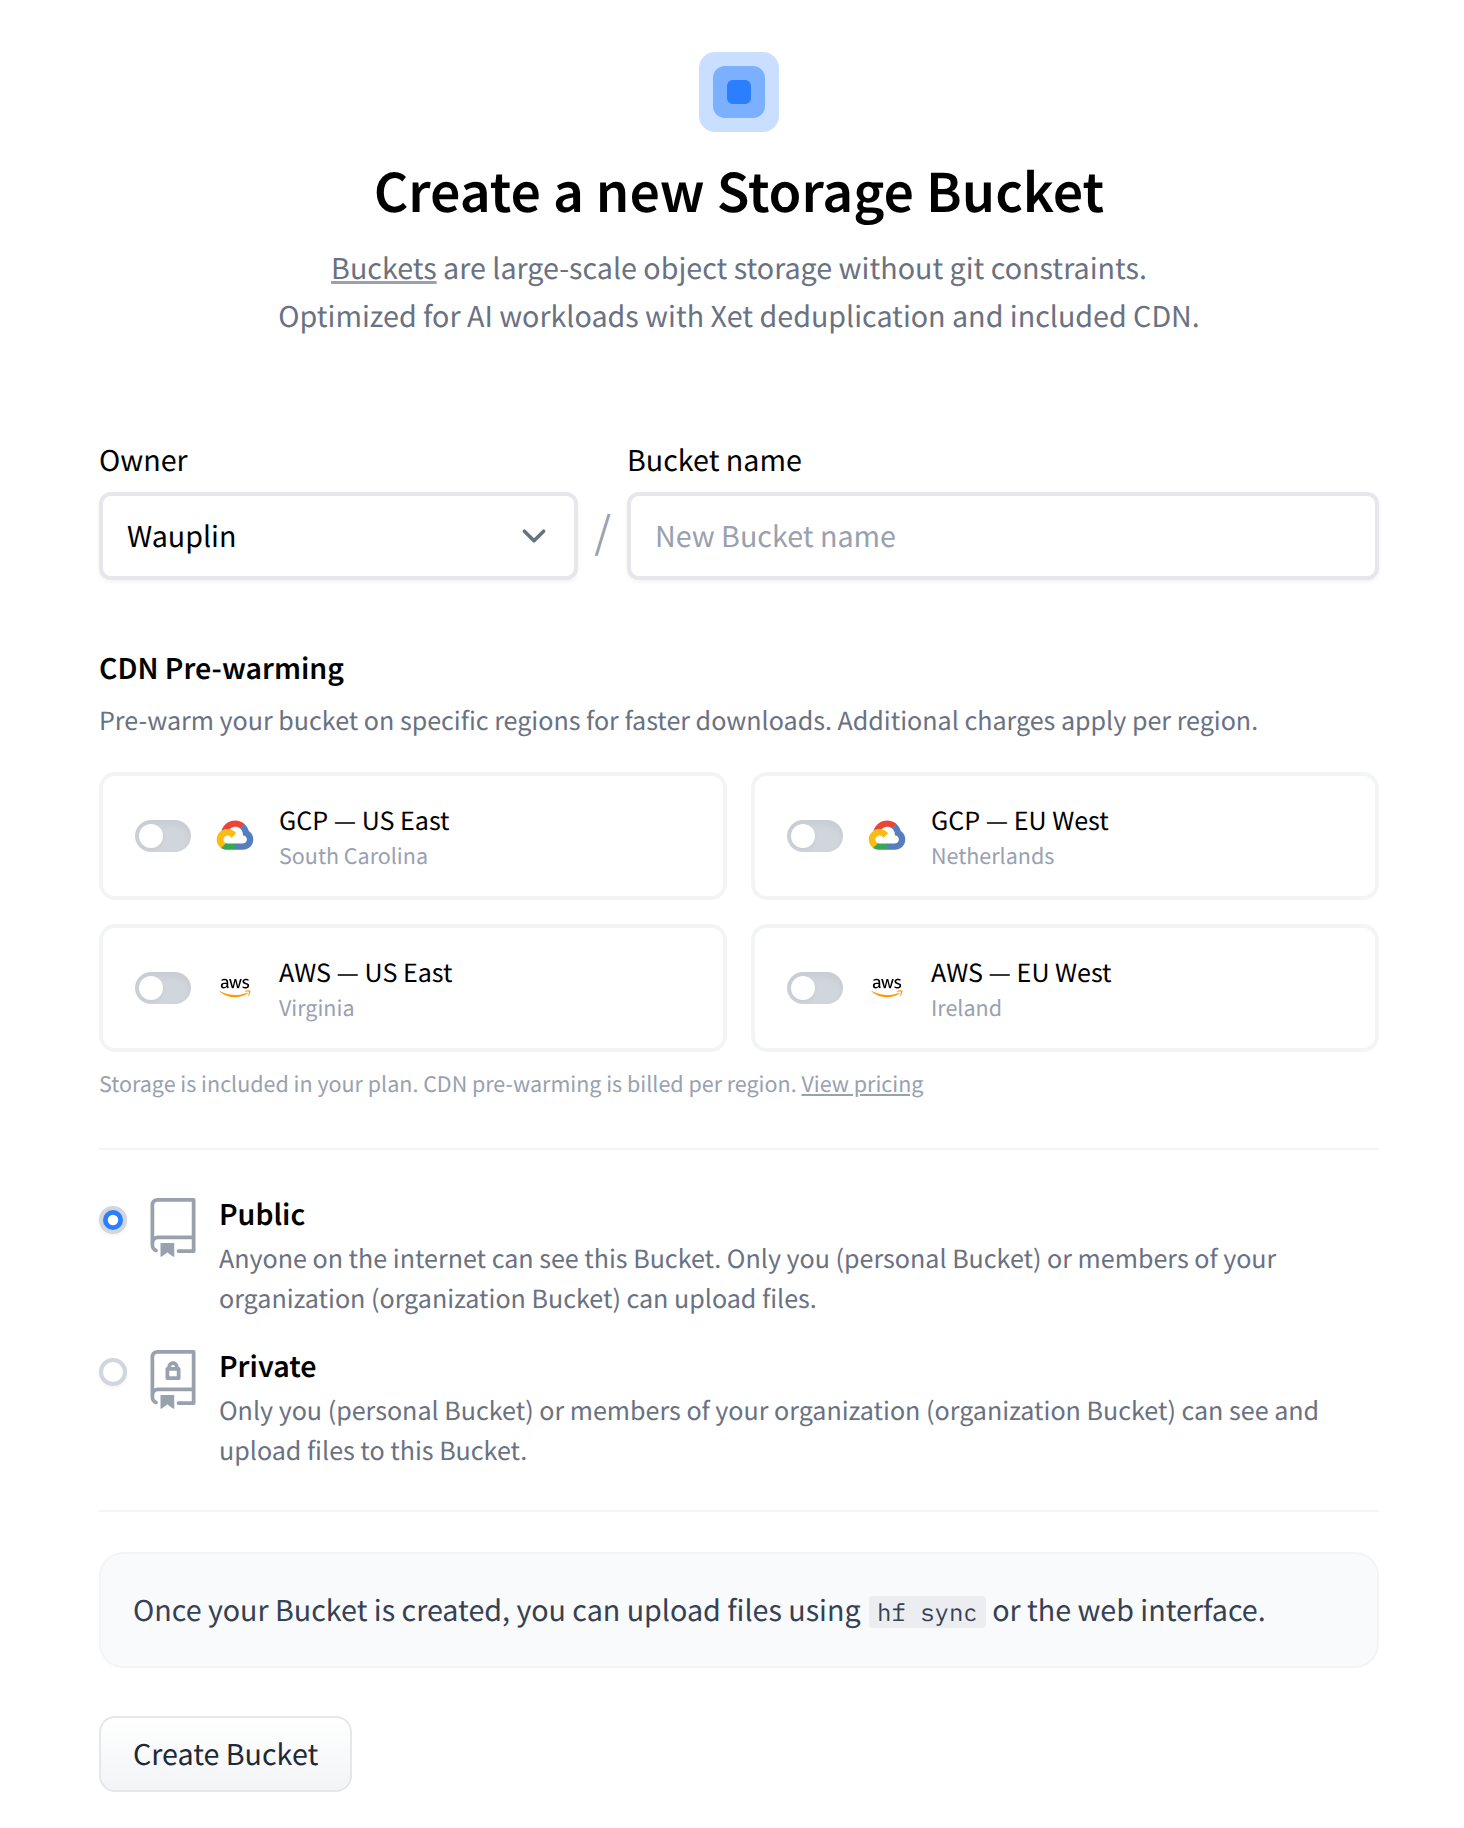
Spécifiez le propriétaire du bucket : il peut s’agir de vous ou de l’une des organisations auxquelles vous êtes affilié.
Saisissez un nom de bucket.
Choisissez si le bucket doit être public ou privé.
En option, pré-sélectionnez les régions de préchauffage du CDN pour mettre en cache vos données plus près de votre calcul dès le départ.
Après avoir créé le bucket, vous devriez voir la page du bucket :
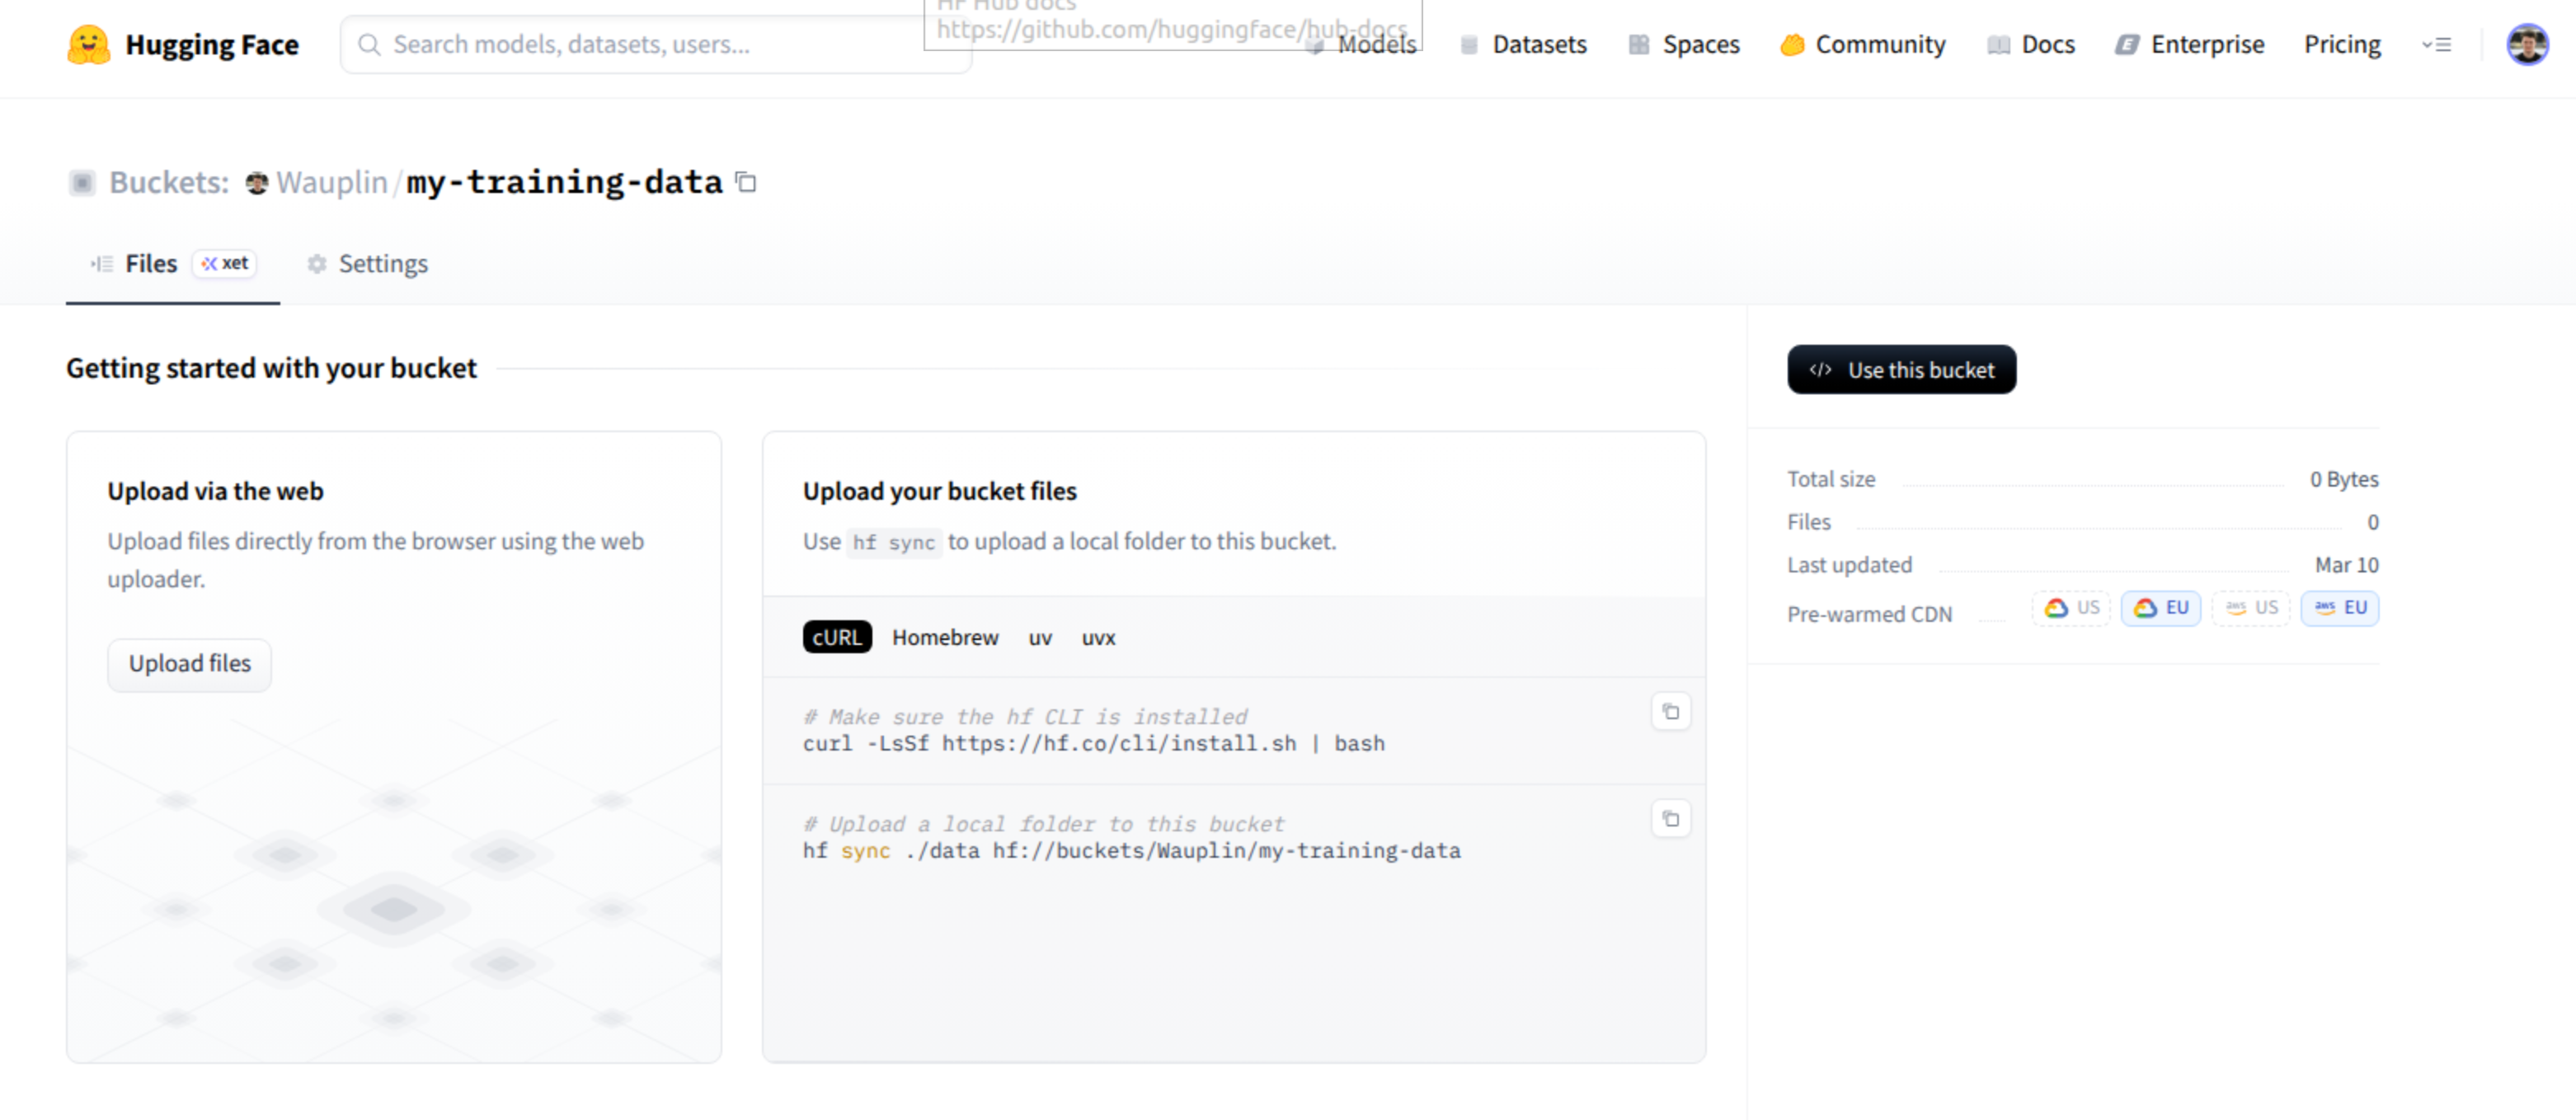
Depuis l'interface en ligne de commande
# Create a bucket under your namespace
hf buckets create my-bucket

# Create a private bucket
hf buckets create my-bucket --private

# Create a bucket under an organization
hf buckets create my-org/shared-bucket
Depuis Python
from huggingface_hub import create_bucket

# Create a bucket under your namespace
create_bucket("my-bucket")

# Create a private bucket
create_bucket("my-bucket", private=True)

# Create a bucket under an organization
create_bucket("my-org/shared-bucket")
Changer la visibilité
Vous pouvez modifier la visibilité d’un bucket après sa création :
# Make a bucket private
hf buckets settings username/my-bucket --private

# Make it public again
hf buckets settings username/my-bucket --publicfrom huggingface_hub import update_bucket_settings
update_bucket_settings("username/my-bucket", private=True)
update_bucket_settings("username/my-bucket", private=False)Pour la référence complète de l’API Python, y compris la suppression, le déplacement et la liste des buckets, consultez le guide des Buckets de huggingface_hub.
Parcourir les buckets sur le Hub
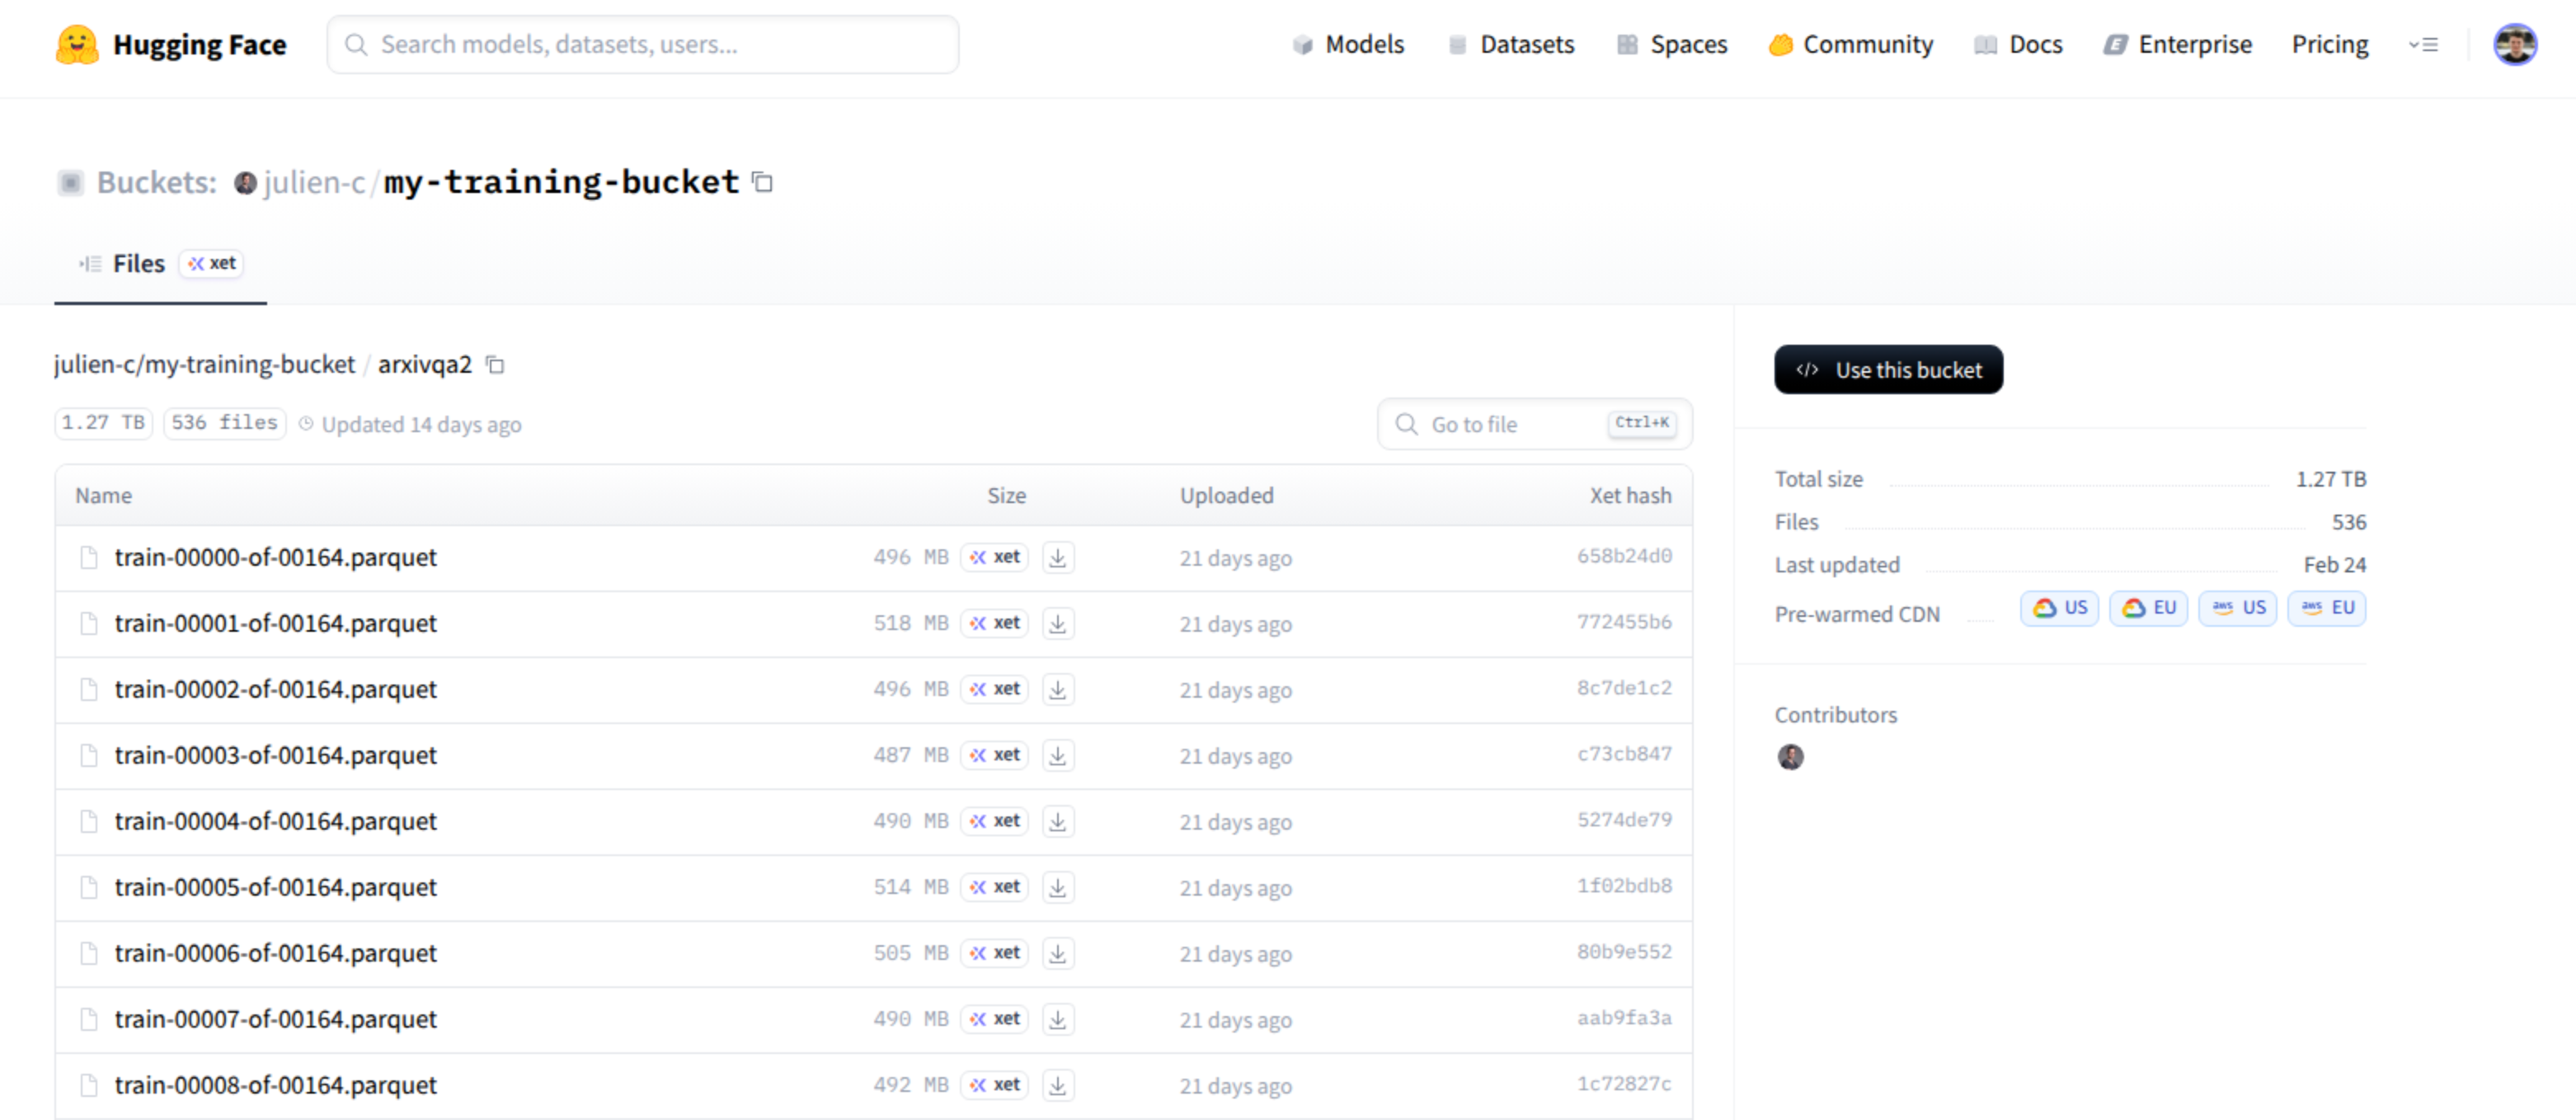
Chaque bucket possède une page sur le Hub où vous pouvez parcourir son contenu, naviguer dans les répertoires et consulter les détails des fichiers. Les pages de bucket sont disponibles à l’adresse https://huggingface.co/buckets/<owner>/<bucket-name>.

Affichage du README
Si un répertoire de votre bucket contient un fichier README.md, le Hub l’affiche sous la liste des fichiers sur la page de ce répertoire. Cela fonctionne aussi bien à la racine du bucket que dans tout sous-répertoire — pratique pour documenter le contenu d’un bucket, l’organisation des données ou la manière dont les outils en aval doivent les consommer.
Listage depuis l'interface en ligne de commande
Vous pouvez également lister le contenu d’un bucket depuis l’interface en ligne de commande :
# List files in a bucket (with human-readable sizes)
hf buckets list julien-c/my-training-bucket -h
                     Feb 17 14:46  art/
                     Feb 17 14:58  arxivqa/
                     Feb 17 15:02  arxivqa2/
                     Feb 17 15:04  arxivqa3/
                     Feb 17 14:47  captcha/
                     Feb 17 14:53  captcha2/
                     Feb 24 17:22  julien/

# Recursive listing
hf buckets list julien-c/my-training-bucket/art -h -R
    423.6 MB         Feb 17 14:29  art/train-00000-of-00011.parquet
    441.0 MB         Feb 17 14:29  art/train-00001-of-00011.parquet
    521.7 MB         Feb 17 14:29  art/train-00002-of-00011.parquet
    481.4 MB         Feb 17 14:29  art/train-00003-of-00011.parquet
    444.6 MB         Feb 17 14:29  art/train-00004-of-00011.parquet
    461.6 MB         Feb 17 14:29  art/train-00005-of-00011.parquet
    466.4 MB         Feb 17 14:29  art/train-00006-of-00011.parquet
    486.3 MB         Feb 17 14:29  art/train-00007-of-00011.parquet
    477.0 MB         Feb 17 14:29  art/train-00008-of-00011.parquet
    454.0 MB         Feb 17 14:29  art/train-00009-of-00011.parquet
    483.1 MB         Feb 17 14:29  art/train-00010-of-00011.parquet

# Tree view
hf buckets list julien-c/my-training-bucket --tree -h -R
                        ├── art/
423.6 MB  Feb 17 14:29  │   ├── train-00000-of-00011.parquet
441.0 MB  Feb 17 14:29  │   ├── train-00001-of-00011.parquet
521.7 MB  Feb 17 14:29  │   ├── train-00002-of-00011.parquet
481.4 MB  Feb 17 14:29  │   ├── train-00003-of-00011.parquet
444.6 MB  Feb 17 14:29  │   ├── train-00004-of-00011.parquet
461.6 MB  Feb 17 14:29  │   ├── train-00005-of-00011.parquet
466.4 MB  Feb 17 14:29  │   ├── train-00006-of-00011.parquet
486.3 MB  Feb 17 14:29  │   ├── train-00007-of-00011.parquet
477.0 MB  Feb 17 14:29  │   ├── train-00008-of-00011.parquet
454.0 MB  Feb 17 14:29  │   ├── train-00009-of-00011.parquet
483.1 MB  Feb 17 14:29  │   └── train-00010-of-00011.parquet
                        ├── arxivqa/
495.9 MB  Feb 17 14:32  │   ├── train-00000-of-00164.parquet
518.3 MB  Feb 17 14:32  │   ├── train-00001-of-00164.parquet
495.5 MB  Feb 17 14:32  │   ├── train-00002-of-00164.parquet
486.6 MB  Feb 17 14:32  │   ├── train-00003-of-00164.parquet
490.4 MB  Feb 17 14:32  │   ├── train-00004-of-00164.parquet
...
Gestion des fichiers
Vous pouvez téléverser et télécharger des fichiers directement depuis la page du bucket sur le Hub, ou utiliser le CLI et l’API Python pour un accès programmatique. Les fichiers du bucket sont référencés à l’aide de chemins hf://buckets/ (par exemple, hf://buckets/username/my-bucket/path/to/file). La commande hf buckets cp gère le transfert de fichiers individuels, tandis que hf buckets sync est plus adaptée aux répertoires. Toutes les commandes fonctionnent dans les deux sens — de local vers distant et de distant vers local.
Si vos données sont déjà dans un dépôt de modèle, de jeu de données ou de Space (ou un autre bucket), vous pouvez les copier côté serveur avec hf buckets cp — aucun téléchargement ni ré-envoi n’est nécessaire. Consultez Copier des fichiers entre dépôts et buckets.
Téléchargement de fichiers
Pour des téléversements rapides, vous pouvez glisser-déposer des fichiers directement sur la page du bucket dans votre navigateur. Pour une utilisation programmatique, hf buckets cp copie des fichiers individuels dans un bucket. La source est un chemin local et la destination est un chemin hf://buckets/. Vous pouvez également acheminer des données depuis stdin, ce qui est pratique pour du contenu généré de manière programmatique.
CLI :
# Upload a single file
hf buckets cp ./model.safetensors hf://buckets/username/my-bucket/models/model.safetensors

# Upload from stdin
cat config.json | hf buckets cp - hf://buckets/username/my-bucket/config.json
En Python, utilisez batch_bucket_files pour téléverser un ou plusieurs fichiers en un seul appel. Chaque entrée est un tuple de la forme (local_path, remote_path).
Python :
from huggingface_hub import batch_bucket_files

batch_bucket_files(
    "username/my-bucket",
    add=[
        ("./model.safetensors", "models/model.safetensors"),
        ("./config.json", "models/config.json"),
    ],
)
Pour plus d'options de téléversement (octets bruts, téléversement + suppression combinés, etc.), consultez le guide de téléversement de huggingface_hub.
Téléchargement de fichiers
Vous pouvez télécharger des fichiers individuels directement depuis la page du bucket sur le Hub en cliquant dessus. Pour un accès programmatique, le téléchargement reprend la syntaxe de téléversement — il suffit d’inverser la source et la destination dans hf buckets cp. Vous pouvez également diffuser un fichier vers la sortie standard en utilisant - comme destination, ce qui permet de transmettre le contenu du bucket directement à d’autres outils.
CLI :
# Download a single file
hf buckets cp hf://buckets/username/my-bucket/models/model.safetensors ./model.safetensors

# Download to stdout and pipe
hf buckets cp hf://buckets/username/my-bucket/config.json - | jq .
En Python, utilisez download_bucket_files avec une liste de tuples (remote_path, local_path).
Python :
from huggingface_hub import download_bucket_files

download_bucket_files(
    "username/my-bucket",
    files=[
        ("models/model.safetensors", "./local/model.safetensors"),
        ("config.json", "./local/config.json"),
    ],
)
Pour des téléchargements plus rapides grâce aux métadonnées pré-récupérées, consultez le guide de téléchargement de huggingface_hub.
Synchronisation des répertoires
La commande sync fonctionne comme rsync ou aws s3 sync — elle compare la source et la destination et ne transfère que les fichiers qui ont changé. C'est la méthode la plus efficace pour maintenir un répertoire local et un bucket synchronisés. Par défaut, sync n'ajoute et ne met à jour que des fichiers. Passez --delete pour supprimer également les fichiers à la destination qui n'existent plus à la source. Utilisez --dry-run pour prévisualiser ce qui se passerait sans réellement transférer quoi que ce soit.
CLI :
# Upload a local directory to a bucket
hf buckets sync ./data hf://buckets/username/my-bucket/data

# Download from a bucket to a local directory
hf buckets sync hf://buckets/username/my-bucket/data ./data

# Sync with deletion of extraneous files
hf buckets sync ./data hf://buckets/username/my-bucket/data --delete

# Preview what would be synced without executing
hf buckets sync ./data hf://buckets/username/my-bucket/data --dry-run

# Plan and apply: review the sync plan before executing
hf buckets sync ./data hf://buckets/username/my-bucket/data --plan sync-plan.jsonl
# ... review the plan file, then apply it
hf buckets sync --apply sync-plan.jsonl
hf syncest un alias pratique pourhf buckets sync.
Python :
from huggingface_hub import sync_bucket

# Upload a local directory to a bucket
sync_bucket("./data", "hf://buckets/username/my-bucket/data")

# Download from a bucket to a local directory
sync_bucket("hf://buckets/username/my-bucket/data", "./data")
La commande sync prend en charge le filtrage (--include, --exclude), les modes de comparaison (--ignore-times, --existing) et un flux de travail plan-and-apply pour examiner les opérations avant de les exécuter. Pour l'ensemble des options, consultez le guide de synchronisation de huggingface_hub.
Suppression de fichiers
Les buckets étant non versionnés, les suppressions sont immédiates et définitives — il est impossible de récupérer un fichier supprimé. Utilisez --dry-run pour vérifier avant de supprimer des fichiers, en particulier lorsque vous utilisez --recursive.
CLI :
# Remove a single file
hf buckets rm username/my-bucket/old-model.bin

# Remove all files under a prefix
hf buckets rm username/my-bucket/logs/ --recursive

# Preview what would be deleted
hf buckets rm username/my-bucket/checkpoints/ --recursive --dry-run
Python :
from huggingface_hub import batch_bucket_files

batch_bucket_files("username/my-bucket", delete=["old-model.bin", "logs/debug.log"])
Pour plus d'options de suppression (filtrage par motif, suppression récursive, etc.), consultez le guide de suppression de huggingface_hub.
Copier des fichiers entre dépôts et buckets
Vous pouvez copier des fichiers suivis par Xet depuis n'importe quel dépôt (modèle, jeu de données, Space) ou bucket vers un bucket de destination sans réenvoyer les données. La copie est effectuée côté serveur : seuls les hachages de contenu Xet sont migrés, si bien que même les fichiers très volumineux sont copiés instantanément grâce à la déduplication au niveau des blocs.
Seuls les fichiers suivis par Xet sont copiés d’un serveur à l’autre. Les petits fichiers non-Xet (par exemple, les fichiers de configuration et les README) sont automatiquement téléchargés puis réenvoyés. La copie côté serveur exige également que la source et la destination se trouvent dans la même région de stockage.
CLI :
hf buckets cp \
  hf://datasets/HuggingFaceFW/fineweb/data \
  hf://buckets/username/fineweb-data
Python :
from huggingface_hub import HfApi

api = HfApi()

api.copy_files(
    "hf://datasets/HuggingFaceFW/fineweb/data",
    "hf://buckets/username/fineweb-data",
)
Vous devez disposer d'un accès en lecture au dépôt ou au bucket source et d'un accès en écriture au bucket de destination.
Notez que le transfert de données dans l'autre sens, d'un bucket vers un dépôt (modèle, jeu de données, Space), sans réimportation, n'est pas encore disponible, mais figure dans la feuille de route.
Suivi des modifications
Les buckets sont mutables, les outils qui conservent une vue d’un bucket — montages, couches de système de fichiers, démons de synchronisation, tableaux de bord — doivent donc savoir quand des fichiers changent. Deux mécanismes sont disponibles :
- Webhooks : des rappels HTTP vers un serveur que vous contrôlez, ou un Job démarré à chaque modification — voir Process new files in a bucket with Jobs.
- Suivi en direct : un flux d'événements envoyés par le serveur auquel votre client s'abonne.
Suivi en direct
GET https://huggingface.co/api/buckets/<owner>/<bucket-name>/events transmet les modifications de fichiers d’un bucket sous forme d’événements envoyés par le serveur. La requête doit inclure Accept: text/event-stream (sinon elle renvoie une erreur 400) et nécessite le même accès en lecture que la liste des éléments du bucket — aucun jeton n’est requis pour un bucket public. Consultez la spécification OpenAPI pour le schéma complet des paramètres et des réponses.
curl -N -H "Accept: text/event-stream" \
  -H "Authorization: Bearer $HF_TOKEN" \
  "https://huggingface.co/api/buckets/username/my-bucket/events"
En Python, vous n’avez pas besoin de consommer le flux vous-même.
HfFileSystemle suit pour vous aveclive_follow=True, de sorte que ses listes en cache restent à jour lorsqu’un autre processus modifie le bucket :from huggingface_hub import HfFileSystem hffs = HfFileSystem(live_follow=True) hffs.ls("buckets/username/my-bucket/data") # starts following the bucketLes bibliothèques qui acceptent
storage_optionsde fsspec (pandas, PyArrow, …) l’acceptent également.
Le flux émet quatre types d'événements :
| Événement | Données | Signification |
|---|---|---|
ready | {"cursor": "..."} | Toute demande de relecture est traitée et les modifications en direct sont appliquées. |
changes | {"cursor": "...", "changes": [...]} | Un lot de modifications de fichiers, fusionné sur une courte fenêtre de temps. |
reset | {"reason": "cursor_too_old"} | Le point de reprise ne peut pas être rejoué ; le flux se termine et vous devez relister le bucket. |
reconnect | {"cursor": "..."} | Le serveur ferme le flux volontairement ; reconnectez-vous avec ce curseur. |
Chaque entrée de changes possède un path et un op (add, update ou delete). Un add ou un update contient également les champs modifiés — size, xetHash, uploadedAt, mtime, mtimeNanos — de sorte qu'un update peut se limiter à un nouveau uploadedAt si un fichier a été réenvoyé de manière identique. Les champs non modifiés sont omis ; mtime/mtimeNanos peuvent également être null si un envoi les a effacés, il faut donc traiter l'absence et null de la même manière.
event: ready
data: {"cursor":"..."}

event: changes
data: {"cursor":"...","changes":[{"path":"data/train.txt","op":"add","size":20,"uploadedAt":"2026-09-16T09:21:45.000Z"},{"path":"data/old.txt","op":"delete"}]}
Reprise. Un nouveau flux démarre au moment où vous vous connectez. Pour également obtenir les modifications que vous avez manquées, passez le dernier cursor reçu (chaque événement ready et changes en contient un) sous la forme ?cursor=<cursor>, ou un horodatage sous la forme ?since=<ISO timestamp> (inclusif, par exemple 2026-09-16T09:21:45Z).
Seules les ~15 dernières minutes de modifications peuvent être rejouées. Si votre cursor ou since est plus ancien, vous recevez reset au lieu d’une rejoue : listez le bucket une fois pour reconstruire votre vue, puis suivez à nouveau à partir du cursor de l’événement ready du nouveau flux. La reprise est conçue pour combler de courtes interruptions, telles qu’une connexion perdue ou un redémarrage ; un client absent plus longtemps doit s’attendre à relister.
Reconnexion. Les connexions de longue durée sont recyclées : environ toutes les 20 minutes (et lors des déploiements), le serveur envoie reconnect puis met fin au flux. Traitez toute fin de flux de la même manière — reconnectez-vous avec le dernier curseur reçu. Un commentaire : ping est envoyé toutes les 30 secondes pour maintenir la connexion active, de sorte qu'un flux totalement silencieux peut être considéré comme mort.
Une réponse 503 signifie que le suivi en direct est momentanément indisponible — réessayez après le délai indiqué dans l'en-tête Retry-After.
Préchauffage et CDN
Les buckets sont stockés par défaut sur le stockage global du Hub. Pour les charges de travail dont le débit dépend directement de l’emplacement du stockage, vous pouvez préchauffer les données du bucket afin de les rapprocher de votre infrastructure de calcul.
Le préchauffage met en cache les fichiers dans des emplacements de bord situés à proximité de fournisseurs de cloud et de régions spécifiques, de sorte que vos tâches lisent les données localement au lieu de les récupérer à travers les régions. Cela est particulièrement utile pour :
- Clusters d'entraînement nécessitant un accès rapide à de grands jeux de données ou à des points de contrôle
- Configurations multi-régions où différentes parties d'un pipeline s'exécutent dans différents clouds
- Distribution d’artefacts volumineux à de nombreux utilisateurs à l’échelle mondiale
Consultez hf.co/storage pour connaître les régions disponibles et les détails sur l’activation du préchauffage.
Cas d'utilisation
Points de contrôle et journaux d'entraînement
Lors de l’exécution de tâches d’entraînement (par exemple via Jobs), enregistrez les points de contrôle et les journaux dans un bucket. Contrairement à un dépôt Git, vous pouvez écraser le dernier point de contrôle sans accumuler d’historique de versions, et sync garantit que seules les données modifiées sont transférées.
# After each evaluation step, sync checkpoints to a bucket
hf sync ./checkpoints hf://buckets/my-org/training-run-42/checkpoints
Étant donné que les buckets sont construits sur Xet, les points de contrôle successifs où de grandes parties du modèle sont figées bénéficient de la déduplication au niveau des chunks. Seuls les chunks modifiés sont téléversés.
Pipelines de traitement des données
Les buckets servent de zones de transit pour les flux de traitement de données. Traitez les données brutes, écrivez les sorties intermédiaires dans un bucket, puis promouvez l’artefact final vers un dépôt Dataset versionné une fois le pipeline terminé. Cela permet de garder votre dépôt versionné propre tout en offrant à votre pipeline un stockage mutable rapide.
Notez que le transfert de données d'un Bucket vers un dépôt sans réupload n'est pas encore disponible, mais figure dans la feuille de route.
Stockage agentique
Les agents IA ont besoin d’un espace de stockage temporaire pour les résultats intermédiaires, les sorties d’outils, les traces et la mémoire de travail. Les buckets offrent un emplacement natif du Hub pour ces données : accès mutable rapide sans surcharge Git, permissions standard de Hugging Face et adressables via des chemins hf://buckets/ dans tout l’écosystème du Hub.
Sauvegardes tournantes
Les buckets sont particulièrement adaptés au maintien de sauvegardes tournantes. Avec un dépôt Dataset basé sur Git, la suppression de fichiers obsolètes ne libère pas l’espace de stockage — l’historique Git conserve toutes les versions passées, il faudrait donc écraser les commits ou réécrire l’historique pour réellement récupérer de l’espace. Avec les buckets, les anciens fichiers sont véritablement supprimés une fois effacés, et vous ne payez que ce qui est actuellement stocké.
# Sync today's backup, removing files that no longer exist locally
hf sync ./daily-backup hf://buckets/my-user/backups/latest --delete
Lier des modèles à des buckets
Vous pouvez créer un lien bidirectionnel entre un modèle et un bucket en ajoutant le champ buckets aux métadonnées de la carte du modèle. Les modèles liés apparaîtront alors sur la page du bucket, et le bucket apparaîtra en tant que tag sur la page du modèle.
# In the model card YAML frontmatter
buckets:
- my-org/my-bucket
Voir Spécifier un bucket dans la documentation des fiches de modèle pour plus de détails.
Tarifs
Les Storage Buckets sont facturés en fonction du volume de données stockées, avec un tarif simple par To. Les plans Enterprise bénéficient d'une facturation basée sur la déduplication, où les segments partagés entre les fichiers réduisent directement l'empreinte facturée.
Comme pour les autres dépôts, les buckets sont gratuits à créer et disposent d'un quota de stockage gratuit. Pour une utilisation au-delà du forfait gratuit, consultez hf.co/storage. Pour des informations générales sur la facturation, reportez-vous à la documentation Billing.
Update on GitHub