
Hub documentation
AIモデルをローカルで利用する
AIモデルをローカルで利用する
HubのAIモデルをローカルで実行できます。これにより、以下の利点を享受できます。
- プライバシー: データをリモートサーバーに送信する必要はありません。
- 速度: ハードウェアがボトルネックであり、サーバーや接続速度ではありません。
- コントロール: お好みに合わせてモデルを設定できます。
- コスト: APIプロバイダーに支払うことなく、モデルをローカルで実行できます。
ローカルアプリの使用方法
Local appsは、Hugging Faceのモデルをあなたのマシン上で直接実行できるアプリケーションです。始めるには:
- ローカルアプリの設定で、ローカルアプリを有効にする。
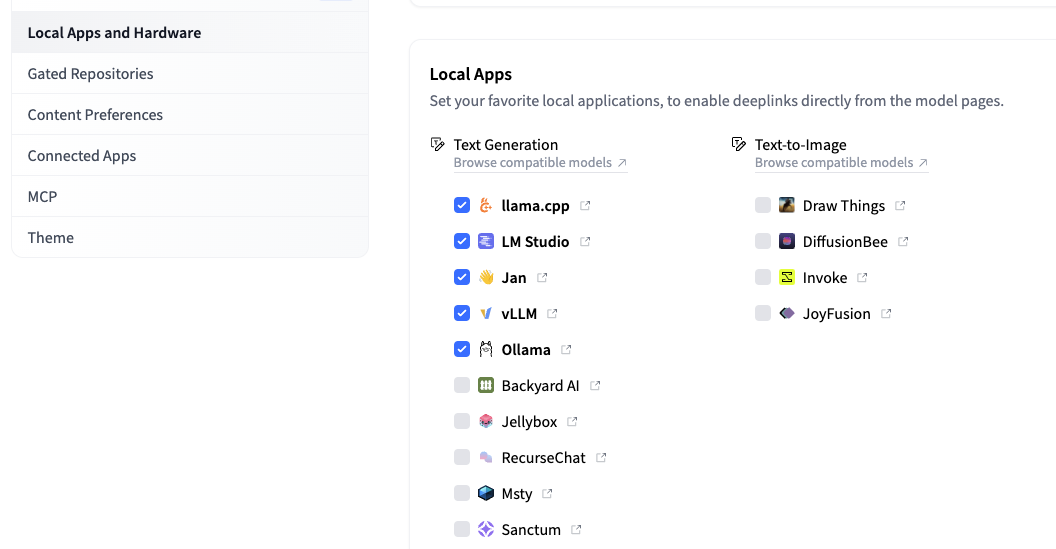
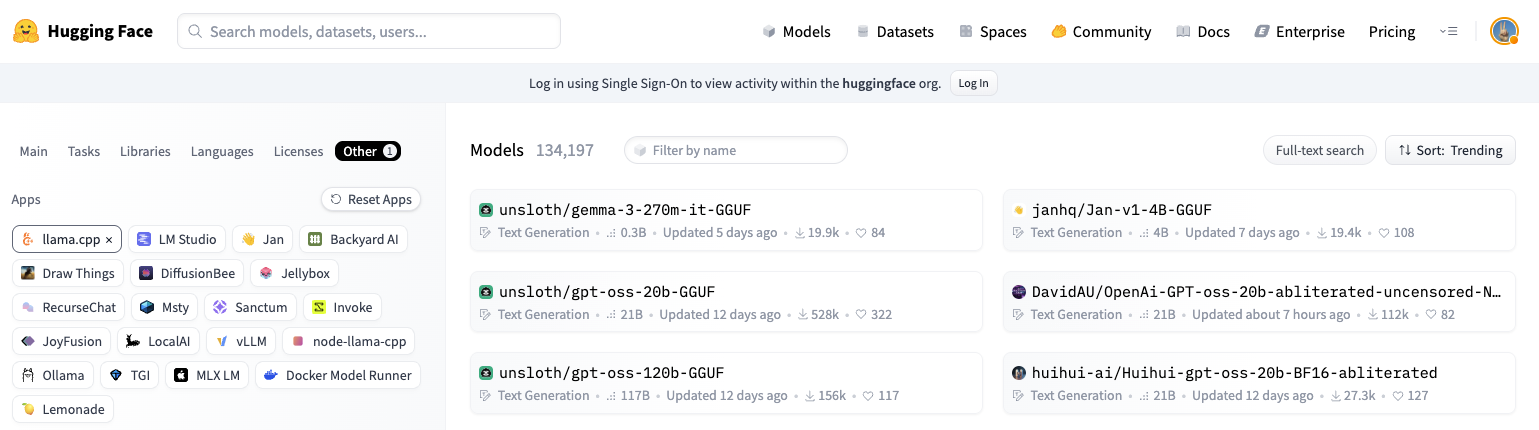
- 対応するモデルを、Hubで検索して選択します。フィルタサイドバーの
OtherセクションのAppsグループでアプリ別に絞り込むことができ、例えばllama.cppと互換性のあるモデルのように指定できます:
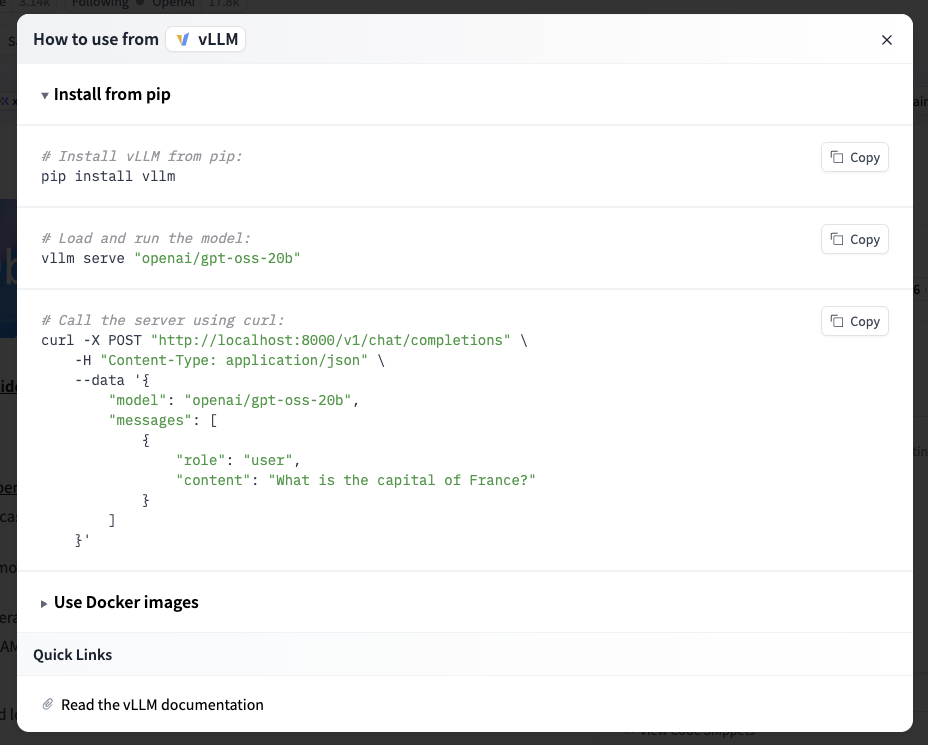
- モデルページの「Use this model」ドロップダウンからローカルアプリを選択します。

- ターミナルで提供されたコマンドをコピーして実行してください。
サポートされているローカルアプリ
サポートされているローカルアプリは、ローカルアプリ設定にリストされています。
モデルページでは、“Use this model”ドロップダウンには、そのモデルが対応しているアプリのみが表示されます(例: llama.cppまたはOllama用のGGUFモデル)。
現在、Hubで利用可能なアプリは以下の通りです:
| アプリ | ウェブサイト | 対応モデル |
|---|---|---|
 Llama | llama.app | GGUF |
 llama.cpp | github.com/ggml-org/llama.cpp | GGUF |
 LM Studio | lmstudio.ai | GGUF、MLX |
 1月 | jan.ai | GGUF |
 Atomic Chat | atomic.chat | GGUF、MLX |
 Unsloth Desktop | unsloth.ai/docs | GGUF、Unslothモデル |
 Ollama | ollama.com | GGUF |
 vLLM | docs.vllm.ai | Transformers、GGUF、AWQ、GPTQのテキスト生成モデルおよび画像テキストからテキストへの変換モデル |
 SGLang | docs.sglang.io | Transformers、AWQ、GPTQのテキスト生成モデルおよび画像テキストからテキストへの変換モデル |
 MLX LM | github.com/ml-explore/mlx-lm | MLXテキスト生成モデル |
 Docker Model Runner | docs.docker.com/ai/model-runner | GGUF、vLLM互換モデル |
 Lemonade | lemonade-server.ai | GGUF、AMD Ryzen AI モデル |
 Pi | github.com/earendil-works/pi | ツール呼び出しに対応したGGUFおよびMLXチャットモデル |
 Hermes Agent | hermes-agent.nousresearch.com | ツール呼び出しに対応したGGUFおよびMLXチャットモデル |
 OpenClaw | github.com/openclaw/openclaw | ツール呼び出しに対応したGGUFおよびMLXチャットモデル |
 Draw Things | drawthings.ai | Diffusersのテキストから画像生成モデルとLoRA |
 DiffusionBee | diffusionbee.com | Diffusersのテキストから画像生成モデル |
 JoyFusion | joyfusion.app | joyfusionタグが付けられたCore MLのテキストから画像生成モデル |
👨💻 これらのローカルアプリを使用するには、上記のようにモデルカードからスニペットをコピーします。
👷 ローカルアプリを構築している場合は、このガイドで Hub との統合について学ぶことができます。
Llama
Llamaは、GGUFモデルをローカルで実行するためのネイティブのmacOSおよびWindowsアプリケーションです。
利点:
- メニューバーまたはタスクバーに常駐する軽量なネイティブアプリ
- HubからのGGUFモデルのワンクリックインストール
- インストール済みモデルによるローカルでプライベートなチャット
- お使いのコンピュータに推奨されるモデルを取得
- Pi、Hermes、OpenClawなどのエージェントと簡単に統合できます
Llamaを使用するには、GGUFモデルのモデルカードに移動し、「このモデルを使用する」をクリックします。Llamaが起動し、モデルのインストールをガイドします。
Llamaは現在、macOSとWindowsの両方で利用可能です。
Llama.cpp
Llama.cppは、CPU、CUDA、Metalなど、さまざまなハードウェア上で推論を最適化してLLMをローカルで実行するための、高性能なC/C++ライブラリです。
利点:
- 複数のCPUファミリー上で、CPUベースのモデルに対して極めて高速なパフォーマンス
- リソース使用量の低さ
- 複数のインターフェースオプション(CLI、Web UIを備えたOpenAI互換サーバー)
- CPUおよびGPU向けにハードウェア最適化
Llama.cpp を使用するには、モデルカードに移動し、「Use this model」をクリックしてコマンドをコピーします。このスニペットには、llama.cpp のインストール(macOS と Linux 用のインストールスクリプト、Windows 用の WinGet、またはソースからのビルド)と、モデルの実行が含まれています。
# Install llama.cpp (macOS, Linux):
curl -LsSf https://llama.app/install.sh | sh

# Start a local OpenAI-compatible server with a web UI:
llama serve -hf unsloth/gpt-oss-20b-GGUF:Q4_K_M

# Or run inference directly in the terminal:
llama cli -hf unsloth/gpt-oss-20b-GGUF:Q4_K_M
llama.cpp + HF 専用ドキュメントページをご覧ください。
LM Studio
Read our dedicated LM Studio doc page
LM Studioは、ローカルLLMのダウンロード、実行、実験を簡単に提供するためのデスクトップアプリケーションです。
利点:
- 直感的なグラフィカルインターフェース
- 組み込みモデルブラウザ
- 開発者ツールとAPI
- 個人利用および商用利用は無料です
GGUFまたはMLXモデルのモデルカードに移動し、「Use this model」をクリックします。LM Studioが起動し、インターフェースを通じてチャットを開始できます。
1月
Janは、ユーザーフレンドリーなインターフェースを備え、完全にオフラインで動作するオープンソースのChatGPT代替ツールです。
利点:
- ユーザーフレンドリーなGUI
- ドキュメントやファイルとチャット
- OpenAI互換のAPIサーバーであり、モデルを実行して他のアプリから利用できます
To use Jan, navigate to the model card of a GGUF model and click “Use this model”. Jan will open and you can start chatting through the interface.
アトミックチャット
Atomic Chatは、ローカルモデルを動作させるためのデスクトップチャットアプリケーションです。
利点:
- グラフィカルなチャットインターフェース
- GGUFモデルとMLXモデルの両方をサポート
Atomic Chat を使用するには、GGUF または MLX モデルのモデルカードに移動し、「Use this model」をクリックします。Atomic Chat が開き、モデルのダウンロードが準備された状態で表示されます。
Unsloth Desktop
Unsloth Desktopは、Unslothが提供するローカルモデルを実行するためのデスクトップアプリケーションです。
利点:
- グラフィカルインターフェース
- GGUFモデルおよびUnslothエコシステムからのモデルと互換性があります
Unsloth Desktop を使用するには、GGUF または Unsloth モデルのモデルカードに移動し、「Use this model」をクリックします。Unsloth Desktop はモデルを開き、モデルのファイルから GGUF ファイルを選択した場合は、そのファイルも開きます。
Ollama
Ollamaは、シンプルなコマンドラインインターフェースを通じて、大規模言語モデルをローカルで実行できるアプリケーションです。GGUFモデルに対応しています。
利点:
- かんたんなインストールとセットアップ
- Hugging Face Hubとの直接統合
Ollamaを使用するには、モデルカードに移動し、「Use this model」をクリックしてコマンドをコピーします。
ollama run hf.co/unsloth/gpt-oss-20b-GGUF:Q4_K_M
vLLM
vLLM は、LLM 向けの高スループットな推論・サービングエンジンであり、OpenAI 互換の API サーバーを備えています。
利点:
- 高スループット、GPU向けに最適化
- Transformers、GGUF、量子化モデル(AWQ、GPTQ)をサポート
- OpenAI互換APIサーバー
vLLMは、テキスト生成モデルおよび画像テキストからテキストへの変換モデルで利用できます。モデルカードに移動し、「Use this model」をクリックして、コマンドをコピーしてください。
# Install vLLM from pip:
pip install vllm

# Start the vLLM server:
vllm serve "openai/gpt-oss-20b"

# Call the server using curl (OpenAI-compatible API):
curl -X POST "http://localhost:8000/v1/chat/completions" \
	-H "Content-Type: application/json" \
	--data '{
		"model": "openai/gpt-oss-20b",
		"messages": [{"role": "user", "content": "What is the capital of France?"}]
	}'
このスニペットは、Docker Model Runnerでモデルを実行する方法も示しています。
SGLang
SGLang は、LLM やビジョン言語モデル向けの高速サービングフレームワークです。
利点:
- GPU上での高性能サービング
- Transformersおよび量子化(AWQ、GPTQ)モデルをサポート
- OpenAI互換APIサーバー
SGLangは、テキスト生成モデルおよび画像テキストからテキストへの変換モデルで利用できます。モデルカードに移動し、「Use this model」をクリックして、コマンドをコピーしてください:
# Install SGLang from pip:
pip install sglang

# Start the SGLang server:
python3 -m sglang.launch_server \
    --model-path "openai/gpt-oss-20b" \
    --host 0.0.0.0 \
--port 30000サーバーはポート30000でOpenAI互換のAPIを公開します。スニペットには、lmsysorg/sglangイメージを使用したDockerコマンドも含まれています。
MLX LM
MLX LMは、AppleのMLXフレームワークを使用してApple silicon上でLLMを実行します。
利点:
- Apple silicon向けに最適化
- コマンドラインからの対話型チャットとテキスト生成
- OpenAI互換サーバー
MLX LM is available for MLX text-generation models. Navigate to the model card, click “Use this model” and copy the commands:
# Install MLX LM
uv tool install mlx-lm

# Interactive chat REPL
mlx_lm.chat --model "mlx-community/Qwen3-4B-4bit"

# Or start an OpenAI-compatible server
mlx_lm.server --model "mlx-community/Qwen3-4B-4bit"
Docker Model Runner
Docker Model Runnerを使用すると、Docker CLIでモデルをプルして実行できます。
利点:
- おなじみのDockerツールを使用します
- GGUFモデルおよびvLLM互換モデルをサポート
モデルカードに移動し、「Use this model」をクリックして、コマンドをコピーします:
docker model run hf.co/unsloth/gpt-oss-20b-GGUF:Q4_K_M
Lemonade
Lemonadeは、AMDハードウェア向けに最適化されたローカルLLMサーバーです。
利点:
- GGUFモデルをサポート
- AMD Ryzen AI NPU用に構築されたモデル(
ryzenai-npuまたはryzenai-hybridタグが付けられたモデル)を実行します
Lemonadeをダウンロードした後、モデルカードに移動し、「Use this model」をクリックして、コマンドをコピーします:
# Pull the model
lemonade pull unsloth/gpt-oss-20b-GGUF:Q4_K_M

# Run and chat with the model
lemonade run user.gpt-oss-20b-GGUF-Q4_K_M

# List all available models
lemonade list
Pi
Piは、ターミナルで実行されるコーディングエージェントです。
Piは、ツール呼び出しに対応するチャットテンプレートを持つGGUFおよびMLXのチャットモデルで利用できます。以下のスニペットでは、まずローカルのOpenAI互換サーバー(GGUFモデルの場合はllama serve、MLXモデルの場合はmlx_lm.server)を起動し、その後Piがそれを使用するように設定します。
# Start a local OpenAI-compatible server:
llama serve -hf unsloth/gpt-oss-20b-GGUF:Q4_K_M

# Install Pi:
npm install -g @earendil-works/pi-coding-agent

# start Pi in your project directory:
pi

# configure Pi to use your llama server:
/login llama.cpp
Hermes Agent
Hermes Agentは、Nous Researchが開発した、ローカルモデルで実行可能なAIエージェントです。
Hermes Agentは、チャットテンプレートがツール呼び出しをサポートするGGUFおよびMLXのチャットモデルで利用できます。以下のスニペットでは、まずローカルのOpenAI互換サーバー(GGUFモデルの場合はllama serve、MLXモデルの場合はmlx_lm.server)を起動し、その後Hermes Agentがそれを使用するように設定します。
# Start a local OpenAI-compatible server:
llama serve -hf unsloth/gpt-oss-20b-GGUF:Q4_K_M

# Install Hermes:
curl -fsSL https://hermes-agent.nousresearch.com/install.sh | bash
hermes setup

# Point Hermes at the local server:
hermes config set model.provider custom
hermes config set model.base_url http://127.0.0.1:8080/v1
hermes config set model.default unsloth/gpt-oss-20b-GGUF:Q4_K_M

# Run Hermes
hermes
OpenClaw
OpenClawは、ローカルモデルで実行できるオープンソースのパーソナルAIエージェントです。
OpenClawは、ツール呼び出しをサポートするチャットテンプレートを持つGGUFおよびMLXのチャットモデルで利用できます。以下のスニペットでは、まずローカルでOpenAI互換サーバー(GGUFモデルの場合はllama serve、MLXモデルの場合はmlx_lm.server)を起動し、その後OpenClawがそのサーバーを使用するように設定します。
# Start a local OpenAI-compatible server:
llama serve -hf unsloth/gpt-oss-20b-GGUF:Q4_K_M

# Install OpenClaw:
npm install -g openclaw@latest

# Register the local server and set it as the default model:
openclaw onboard --non-interactive --mode local \
  --auth-choice custom-api-key \
  --custom-base-url http://127.0.0.1:8080/v1 \
  --custom-model-id "unsloth/gpt-oss-20b-GGUF:Q4_K_M" \
  --custom-provider-id llama-cpp \
  --custom-compatibility openai \
  --custom-text-input \
  --accept-risk \
  --skip-health

# Run OpenClaw
openclaw agent --local --agent main --message "Hello from Hugging Face"
Draw Things
Draw Thingsは、Appleデバイス上でローカルに画像を生成するためのアプリです。
利点:
- テキストから画像を生成するモデルを完全にオンデバイスで実行します
- ベースモデルとLoRAの両方をインポートできます
Draw Things を使用するには、Diffusers のテキストから画像生成モデルまたは LoRA のモデルカードに移動し、「Use this model」をクリックしてください。Draw Things が起動し、モデルがインポートされます。
Draw ThingsはmacOSでのみ利用できます。
DiffusionBee
DiffusionBeeは、Stable Diffusionモデルを使用してローカルで画像を生成するためのデスクトップアプリです。
利点:
- シンプルなグラフィカルインターフェース
- セットアップやコマンドラインは不要です
DiffusionBee を使用するには、Diffusers のテキストから画像を生成するモデルのモデルカードに移動し、「このモデルを使用する」をクリックします。DiffusionBee が起動し、モデルがインポートされます。
DiffusionBeeはmacOSでのみ利用できます。
JoyFusion
JoyFusionは、Appleデバイス上でCore MLモデルを使用してローカルで画像を生成するためのアプリです。
JoyFusion を使用するには、joyfusion タグが付けられた Core ML のテキストから画像生成モデルのモデルカードに移動し、「Use this model」をクリックします。JoyFusion が起動し、モデルがインポートされます。
Update on GitHubJoyFusionはmacOSでのみ利用できます。