Transformers documentation
Обнаружение объектов
Обнаружение объектов
Обнаружение объектов — это задача компьютерного зрения, состоящая в определении экземпляров объектов (например, людей, зданий или автомобилей) на изображении. Модели обнаружения объектов принимают на вход изображение и на выходе предоставляют координаты ограничивающих прямоугольников и соответствующие им метки обнаруженных объектов. На одном изображении может присутствовать несколько объектов, каждый со своим ограничивающим прямоугольником и меткой (например, автомобиль и здание), при этом каждый объект может находиться в разных частях изображения (например, на изображении может быть несколько автомобилей). Эта задача широко применяется в автономном вождении для обнаружения таких объектов, как пешеходы, дорожные знаки и светофоры. Среди других приложений — подсчёт объектов на изображениях, поиск по изображениям и многое другое.
В этом руководстве вы узнаете, как:
- Настройте RF-DETR на датасете mobile-ui-design для обнаружения элементов пользовательского интерфейса на скриншотах мобильных приложений.
- Используйте вашу дообученную модель для инференса.
Чтобы увидеть все архитектуры и контрольные точки, совместимые с этой задачей, рекомендуем обратиться к странице задачи
Прежде чем начать, убедитесь, что у вас установлены все необходимые библиотеки:
pip install -q datasets transformers accelerate timm trackio torchmetrics pycocotools
Вы будете использовать 🤗 Datasets для загрузки набора данных из Hugging Face Hub и 🤗 Transformers для обучения модели.
Мы рекомендуем делиться вашей моделью с сообществом. Войдите в свой аккаунт Hugging Face, чтобы загрузить её на Hub. При запросе введите токен для входа:
>>> from huggingface_hub import notebook_login

>>> notebook_login()
Определите глобальные константы, а именно имя модели и размер изображения. В этом учебном материале используется RF-DETR, но вы можете выбрать любую модель обнаружения объектов в Transformers.
>>> MODEL_NAME = "Roboflow/rf-detr-medium"Загрузите набор данных mobile-ui-design
Набор данных mobile-ui-design содержит скриншоты мобильных приложений с аннотациями для обнаружения элементов пользовательского интерфейса, таких как текст, изображения, прямоугольники и группы.
Начните с загрузки набора данных и извлечения меток категорий. В наборе данных уже есть разбиения.
>>> from datasets import load_dataset

>>> ds = load_dataset("merve/mobile-ui-design")

>>> CATEGORIES = sorted(set(
...     cat for split in ds.values() for example in split for cat in example["objects"]["category"]
... ))
>>> label2id = {label: i for i, label in enumerate(CATEGORIES)}
>>> id2label = {i: label for label, i in label2id.items()}
>>> print(f"Categories ({len(CATEGORIES)}): {CATEGORIES}")
Categories (4): ['group', 'image', 'rectangle', 'text']
Набор данных использует строковые имена категорий и ограничивающие рамки в формате COCO (x, y, w, h). Перед обучением преобразуйте категории в целочисленные идентификаторы, вычислите площади и отфильтруйте вырожденные ограничивающие рамки:
>>> def prepare_example(example, idx):
...     objects = example["objects"]
...     in_bboxes = objects["bbox"]
...     categories = objects["category"]
...     img_w, img_h = example["width"], example["height"]
...     bboxes, cats, areas, ids = [], [], [], []
...     for i, (bbox, cat) in enumerate(zip(in_bboxes, categories)):
...         x, y, w, h = bbox
...         if w <= 0 or h <= 0:
...             continue
...         x = max(0.0, min(x, img_w))
...         y = max(0.0, min(y, img_h))
...         w = min(w, img_w - x)
...         h = min(h, img_h - y)
...         if w <= 0 or h <= 0:
...             continue
...         bboxes.append([x, y, w, h])
...         cats.append(label2id[cat])
...         areas.append(w * h)
...         ids.append(i)
...     return {
...         "image_id": idx, "image": example["image"],
...         "width": example["width"], "height": example["height"],
...         "objects": {"id": ids, "bbox": bboxes, "category": cats, "area": areas},
...     }

>>> ds_prepared = ds["train"].map(prepare_example, with_indices=True, remove_columns=ds["train"].column_names)
>>> ds_prepared = ds_prepared.filter(lambda x: len(x["objects"]["bbox"]) > 0)

>>> split = ds_prepared.train_test_split(test_size=0.15, seed=1337)
>>> train_ds = split["train"]
>>> val_ds = split["test"]
>>> print(f"Train: {len(train_ds)}, Validation: {len(val_ds)}")
Train: 6669, Validation: 1177
Предобработка данных
AutoImageProcessor отвечает за обработку изображений с целью создания pixel_values, pixel_mask и labels, на которых обучается модель. Процессор изображений выполняет изменение размера, добавление отступов и нормализацию. Кроме того, вы можете по желанию добавить случайные преобразования данных (см. ниже) для улучшения обобщающей способности.
>>> import numpy as np
>>> from functools import partial
>>> from transformers import AutoImageProcessor

>>> image_processor = AutoImageProcessor.from_pretrained(MODEL_NAME)
Объект image_processor ожидает аннотации в формате COCO: {'image_id': int, 'annotations': list[Dict]}. Сформируйте аннотации для каждого примера, а остальное обработчик возьмет на себя:
>>> def format_image_annotations_as_coco(image_id, categories, areas, bboxes):
...     annotations = []
...     for category, area, bbox in zip(categories, areas, bboxes):
...         annotations.append({
...             "image_id": image_id,
...             "category_id": category,
...             "iscrowd": 0,
...             "area": area,
...             "bbox": list(bbox),
...         })
...     return {"image_id": image_id, "annotations": annotations}

>>> def transform_batch(examples, image_processor):
...     images = []
...     annotations = []
...     for image_id, image, objects in zip(examples["image_id"], examples["image"], examples["objects"]):
...         images.append(np.array(image.convert("RGB")))
...         formatted = format_image_annotations_as_coco(
...             image_id, objects["category"], objects["area"], objects["bbox"]
...         )
...         annotations.append(formatted)
...     result = image_processor(images=images, annotations=annotations, return_tensors="pt")
...     result.pop("pixel_mask", None)
...     return result

>>> transform_fn = partial(transform_batch, image_processor=image_processor)
>>> train_ds = train_ds.with_transform(transform_fn)
>>> val_ds = val_ds.with_transform(transform_fn)
Аугментация данных
Преобразование выше выполняет только изменение размера и нормализацию изображений. Случайные аугментации, применяемые к разбиению training, как правило, улучшают обобщение, тогда как разбиение валидации должно оставаться без аугментаций, чтобы оценка оставалась детерминированной. Распространённым выбором является Albumentations, который аугментирует изображение и его ограничивающие рамки совместно. Определите конвейер с bbox_params, чтобы рамки трансформировались согласованно с изображением, а затем пересчитайте площади по аугментированным рамкам:
>>> import albumentations as A

>>> train_augment = A.Compose(
...     [
...         A.Perspective(p=0.1),
...         A.HorizontalFlip(p=0.5),
...         A.RandomBrightnessContrast(p=0.5),
...         A.HueSaturationValue(p=0.1),
...     ],
...     bbox_params=A.BboxParams(format="coco", label_fields=["category"], clip=True, min_area=25),
... )

>>> def augment_and_transform_batch(examples, image_processor, transform):
...     images = []
...     annotations = []
...     for image_id, image, objects in zip(examples["image_id"], examples["image"], examples["objects"]):
...         image = np.array(image.convert("RGB"))
...         output = transform(image=image, bboxes=objects["bbox"], category=objects["category"])
...         images.append(output["image"])
...         areas = [w * h for (_, _, w, h) in output["bboxes"]]
...         formatted = format_image_annotations_as_coco(
...             image_id, output["category"], areas, output["bboxes"]
...         )
...         annotations.append(formatted)
...     result = image_processor(images=images, annotations=annotations, return_tensors="pt")
...     result.pop("pixel_mask", None)
...     return result
Примените трансформацию аугментации только к обучающей выборке, а для валидации оставьте обычную transform_fn:
>>> train_augment_fn = partial(augment_and_transform_batch, image_processor=image_processor, transform=train_augment)
>>> train_ds = train_ds.with_transform(train_augment_fn)
>>> val_ds = val_ds.with_transform(transform_fn)
Создайте собственную collate_fn для пакетирования изображений:
>>> import torch

>>> def collate_fn(batch):
...     data = {}
...     data["pixel_values"] = torch.stack([x["pixel_values"] for x in batch])
...     data["labels"] = [x["labels"] for x in batch]
...     if "pixel_mask" in batch[0]:
...         data["pixel_mask"] = torch.stack([x["pixel_mask"] for x in batch])
...     return data
Подготовка функции для вычисления mAP
Модели обнаружения объектов обычно оцениваются с помощью набора метрик в стиле COCO. Мы будем использовать torchmetrics для вычисления метрик mAP (средняя средняя точность) и mAR (средняя средняя полнота) и обернем их в функцию compute_metrics, чтобы использовать в Trainer для оценки.
Промежуточный формат рамок, используемый для обучения, — это YOLO (нормализованный), однако для корректной обработки площадей рамок метрики будут вычисляться в формате Pascal VOC (абсолютные значения). Определим функцию, преобразующую рамки в формат Pascal VOC:
>>> from transformers.image_transforms import center_to_corners_format

>>> def convert_bbox_yolo_to_pascal(boxes, image_size):
...     """
...     Convert bounding boxes from YOLO format (x_center, y_center, width, height) in range [0, 1]
...     to Pascal VOC format (x_min, y_min, x_max, y_max) in absolute coordinates.

...     Args:
...         boxes (torch.Tensor): Bounding boxes in YOLO format
...         image_size (tuple[int, int]): Image size in format (height, width)

...     Returns:
...         torch.Tensor: Bounding boxes in Pascal VOC format (x_min, y_min, x_max, y_max)
...     """
...     # convert center to corners format
...     boxes = center_to_corners_format(boxes)

...     # convert to absolute coordinates
...     height, width = image_size
...     boxes = boxes * torch.tensor([[width, height, width, height]])

...     return boxes
Затем в функции compute_metrics мы собираем предсказанные predicted и целевые target ограничивающие рамки, оценки и метки из результатов цикла оценки и передаём их в функцию подсчёта метрик.
>>> import numpy as np
>>> from dataclasses import dataclass
>>> from torchmetrics.detection.mean_ap import MeanAveragePrecision


>>> @dataclass
>>> class ModelOutput:
...     logits: torch.Tensor
...     pred_boxes: torch.Tensor


>>> def _get_orig_size(image_target):
...     """Robust orig_size extraction - Trainer serialization can truncate to 1 element."""
...     orig = np.atleast_1d(np.asarray(image_target["orig_size"])).flatten()
...     if len(orig) >= 2:
...         return (int(orig[0]), int(orig[1]))
...     return (int(orig[0]), int(orig[0]))

>>> @torch.no_grad()
>>> def compute_metrics(evaluation_results, image_processor, threshold=0.0, id2label=None):
...     predictions, targets = evaluation_results.predictions, evaluation_results.label_ids
...     image_sizes = []
...     post_processed_targets = []
...     post_processed_predictions = []
...
...     for batch in targets:
...         batch_sizes = []
...         for image_target in batch:
...             h, w = _get_orig_size(image_target)
...             batch_sizes.append([h, w])
...             boxes = torch.tensor(image_target["boxes"])
...             boxes = convert_bbox_yolo_to_pascal(boxes, (h, w))
...             labels = torch.tensor(image_target["class_labels"])
...             post_processed_targets.append({"boxes": boxes, "labels": labels})
...         image_sizes.append(torch.tensor(batch_sizes))
...
...     for batch, target_sizes in zip(predictions, image_sizes):
...         batch_logits, batch_boxes = batch[1], batch[2]
...         output = ModelOutput(logits=torch.tensor(batch_logits), pred_boxes=torch.tensor(batch_boxes))
...         post_processed_output = image_processor.post_process_object_detection(
...             output, threshold=threshold, target_sizes=target_sizes
...         )
...         post_processed_predictions.extend(post_processed_output)
...
...     metric = MeanAveragePrecision(box_format="xyxy", class_metrics=True)
...     metric.update(post_processed_predictions, post_processed_targets)
...     metrics = metric.compute()
...
...     classes = metrics.pop("classes")
...     map_per_class = metrics.pop("map_per_class")
...     mar_100_per_class = metrics.pop("mar_100_per_class")
...     for class_id, class_map, class_mar in zip(classes, map_per_class, mar_100_per_class):
...         class_name = id2label[class_id.item()] if id2label is not None else class_id.item()
...         metrics[f"map_{class_name}"] = class_map
...         metrics[f"mar_100_{class_name}"] = class_mar
...
...     metrics = {k: round(v.item(), 4) for k, v in metrics.items()}
...     return metrics

>>> eval_compute_metrics_fn = partial(
...     compute_metrics, image_processor=image_processor, id2label=id2label, threshold=0.0
... )
Обучение модели обнаружения
В предыдущих разделах вы выполнили основную работу, поэтому теперь вы готовы обучать свою модель! Изображения в этом датасете по-прежнему достаточно большие, даже после изменения размера. Это означает, что дообучение этой модели потребует как минимум одного GPU.
Обучение включает следующие шаги:
- Загрузите модель с помощью AutoModelForObjectDetection, используя тот же чекпоинт, что и при предобработке.
- Определите гиперпараметры обучения в TrainingArguments.
- Передайте аргументы обучения в Trainer вместе с моделью, набором данных, процессором изображений и коллаборатором данных.
- Вызовите train(), чтобы дообучить модель.
При загрузке модели из того же контрольного пункта, который вы использовали для предобработки, не забудьте передать карты label2id и id2label, созданные ранее из метаданных набора данных. Кроме того, мы указываем ignore_mismatched_sizes=True, чтобы заменить существующую голову классификации новой.
>>> from transformers import AutoModelForObjectDetection

>>> model = AutoModelForObjectDetection.from_pretrained(
...     MODEL_NAME,
...     id2label=id2label,
...     label2id=label2id,
...     ignore_mismatched_sizes=True,
... )
В TrainingArguments используйте output_dir, чтобы указать, куда сохранять модель, а затем настройте гиперпараметры по своему усмотрению. При num_train_epochs=5 обучение займёт около 35 минут на GPU A100; увеличьте количество эпох, чтобы получить лучшие результаты.
Важные примечания:
- Не удаляйте неиспользуемые столбцы, так как это приведёт к удалению столбца с изображениями. Без столбца с изображениями невозможно создать
pixel_values. По этой причине установите дляremove_unused_columnsзначениеFalse. - Установите
eval_do_concat_batches=False, чтобы получить корректные результаты оценки. У изображений разное количество целевых рамок; если батчи будут склеены, невозможно будет определить, какие рамки относятся к конкретному изображению.
Если вы хотите поделиться своей моделью, отправив её на Hub, установите push_to_hub в значение True (для загрузки модели необходимо войти в аккаунт Hugging Face).
>>> from transformers import TrainingArguments

>>> training_args = TrainingArguments(
...     output_dir="rf_detr_finetuned_mobile_ui",
...     num_train_epochs=5,
...     bf16=True,
...     per_device_train_batch_size=8,
...     dataloader_num_workers=4,
...     learning_rate=5e-5,
...     lr_scheduler_type="cosine",
...     weight_decay=1e-4,
...     max_grad_norm=0.01,
...     metric_for_best_model="eval_map",
...     greater_is_better=True,
...     load_best_model_at_end=True,
...     eval_strategy="epoch",
...     save_strategy="epoch",
...     save_total_limit=2,
...     remove_unused_columns=False,
...     report_to="trackio",
...     run_name="mobile-ui-detection",
...     eval_do_concat_batches=False,
...     push_to_hub=True,
... )
Наконец, соберите всё вместе и вызовите train():
>>> from transformers import Trainer

>>> trainer = Trainer(
...     model=model,
...     args=training_args,
...     train_dataset=train_ds,
...     eval_dataset=val_ds,
...     processing_class=image_processor,
...     data_collator=collate_fn,
...     compute_metrics=eval_compute_metrics_fn,
... )

>>> trainer.train()| Эпоха | Потери обучения | Потери валидации | Карта | Map 50 | Карта 75 | Map Small | Карта Medium | Map Large | 1 марта | 10 марта | 100 марта | Mar Small | Mar Средний | Mar Large | Группа Map | Mar 100 Group | Карта изображения | Mar 100 Изображение | Карта прямоугольника | Mar 100 Прямоугольник | Карта текста | Mar 100 Text |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | Нет журнала | 9.9234 | 0.1303 | 0.2236 | 0.1478 | 0.0909 | 0.2030 | 0.2524 | 0.0421 | 0.2520 | 0.4683 | 0.3113 | 0.5607 | 0.6782 | 0.1244 | 0.5122 | 0.0958 | 0.5035 | 0.1285 | 0.4328 | 0.1725 | 0.4413 |
| 2 | Нет журнала | 9.8472 | 0.1893 | 0.3017 | 0.2124 | 0.1347 | 0.2789 | 0.3038 | 0.0549 | 0.2961 | 0.5140 | 0.3433 | 0.5941 | 0.7406 | 0.1305 | 0.5423 | 0.1979 | 0.5578 | 0.1964 | 0.4648 | 0.2324 | 0.4437 |
| 3 | Нет журнала | 9.6401 | 0.2275 | 0.3547 | 0.2657 | 0.1698 | 0.3336 | 0.3892 | 0.0611 | 0.3204 | 0.5270 | 0.3625 | 0.6143 | 0.7496 | 0.1602 | 0.5684 | 0.2617 | 0.5763 | 0.2249 | 0.4684 | 0.2631 | 0.4692 |
| 4 | Нет журнала | 9.5770 | 0.2733 | 0.4068 | 0.3133 | 0.2100 | 0.3867 | 0.4343 | 0.0668 | 0.3456 | 0.5593 | 0.3875 | 0.6393 | 0.7725 | 0.2013 | 0.5941 | 0.3158 | 0.6065 | 0.2733 | 0.4998 | 0.3028 | 0.4756 |
| 5 | 10.3700 | 11.0500 | 0.2827 | 0.4193 | 0.2913 | 0.2021 | 0.2814 | 0.3763 | 0.0609 | 0.3403 | 0.5668 | 0.4138 | 0.5669 | 0.7317 | 0.2092 | 0.5979 | 0.3334 | 0.6295 | 0.2793 | 0.5245 | 0.3089 | 0.5151 |
Если в training_args параметр push_to_hub установлен в True, контрольные точки обучения будут загружены на Hugging Face Hub. По завершении обучения также загрузите итоговую модель на Hub, вызвав метод push_to_hub().
>>> trainer.push_to_hub()Оценка
>>> from pprint import pprint

>>> metrics = trainer.evaluate(eval_dataset=val_ds, metric_key_prefix="test")
>>> pprint(metrics)
{'test_loss': 11.05,
 'test_map': 0.2827,
 'test_map_50': 0.4193,
 'test_map_75': 0.2913,
 'test_map_group': 0.2092,
 'test_map_image': 0.3334,
 'test_map_large': 0.3763,
 'test_map_medium': 0.2814,
 'test_map_rectangle': 0.2793,
 'test_map_small': 0.2021,
 'test_map_text': 0.3089,
 'test_mar_1': 0.0609,
 'test_mar_10': 0.3403,
 'test_mar_100': 0.5668,
 'test_mar_100_group': 0.5979,
 'test_mar_100_image': 0.6295,
 'test_mar_100_rectangle': 0.5245,
 'test_mar_100_text': 0.5151,
 'test_mar_large': 0.7317,
 'test_mar_medium': 0.5669,
 'test_mar_small': 0.4138}
Эти результаты можно улучшить, увеличив количество эпох или отрегулировав другие гиперпараметры в TrainingArguments. Попробуйте!
Вывод
Теперь, когда вы дообучили модель, оценили её и загрузили на Hugging Face Hub, вы можете использовать её для инференса.
>>> import torch
>>> from PIL import Image, ImageDraw
>>> from transformers import AutoImageProcessor, AutoModelForObjectDetection
>>> from datasets import load_dataset

>>> ds = load_dataset("merve/mobile-ui-design", split="train")
>>> image = ds[5]["image"].convert("RGB")
Загрузите модель и процессор изображений из Hugging Face Hub (пропустите, если они уже обучены в этой сессии):
>>> model_repo = "merve/rf_detr_finetuned_mobile_ui"

>>> image_processor = AutoImageProcessor.from_pretrained(model_repo)
>>> model = AutoModelForObjectDetection.from_pretrained(model_repo)
>>> model.eval()
И обнаружение ограничивающих прямоугольников:
>>> with torch.no_grad():
...     inputs = image_processor(images=[image], return_tensors="pt")
...     outputs = model(**inputs)
...     target_sizes = torch.tensor([[image.size[1], image.size[0]]])
...     results = image_processor.post_process_object_detection(outputs, threshold=0.5, target_sizes=target_sizes)[0]

>>> for score, label, box in zip(results["scores"], results["labels"], results["boxes"]):
...     box = [round(i, 2) for i in box.tolist()]
...     print(
...         f"Detected {model.config.id2label[label.item()]} with confidence "
...         f"{round(score.item(), 3)} at location {box}"
...     )
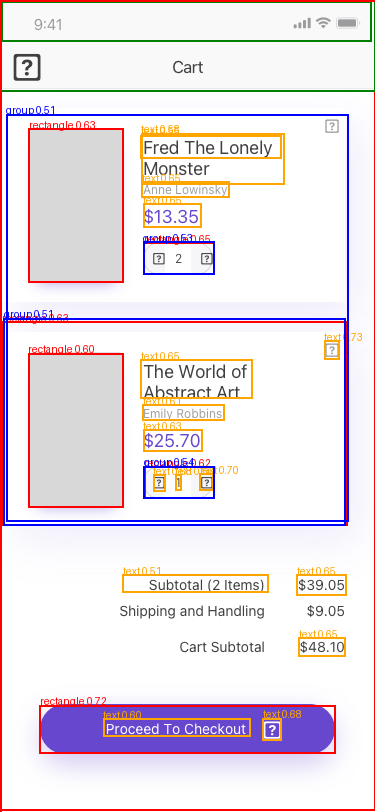
Detected text with confidence 0.727 at location [324.02, 340.55, 339.52, 359.12]
Detected rectangle with confidence 0.717 at location [39.97, 705.14, 335.93, 753.54]
Detected text with confidence 0.702 at location [199.94, 473.66, 213.41, 490.6]
Detected text with confidence 0.678 at location [153.14, 474.81, 165.33, 491.0]
Detected text with confidence 0.675 at location [262.67, 718.28, 281.44, 740.81]
Detected rectangle with confidence 0.655 at location [143.57, 242.51, 214.32, 274.26]
Detected text with confidence 0.653 at location [298.68, 637.77, 345.68, 656.26]
Построим график результата:
>>> draw = ImageDraw.Draw(image)

>>> colors = {"group": "blue", "image": "green", "rectangle": "red", "text": "orange"}
>>> for score, label, box in zip(results["scores"], results["labels"], results["boxes"]):
...     box = [round(i, 2) for i in box.tolist()]
...     x, y, x2, y2 = tuple(box)
...     label_name = model.config.id2label[label.item()]
...     color = colors.get(label_name, "red")
...     draw.rectangle((x, y, x2, y2), outline=color, width=2)
...     draw.text((x, y), f"{label_name} {score:.2f}", fill=color)

>>> image