
Transformers documentation
GLM-5.3-Flash
このモデルは2026年8月26日にHugging Face Transformersに貢献されました。
GLM-5.3-Flash
概要
GLM-5.3-Flashモデルはこのクラスを使用しています。transformersの実装にはMTPレイヤーは含まれていません。
GLM-5.3-Flash
GLM-5.3-Flashは、GLM-5シリーズで初めてネイティブにマルチモーダル対応したモデルです。総パラメータ数は320B、アクティブパラメータ数はわずか18Bであり、コストを1/10に抑えながら、ベンチマークおよび実環境でのワークロードにおいてGLM-5.2を上回る性能を発揮します。また、コーディングおよびエージェント系のベンチマークでは、Claude Opus 4.8に迫る性能を示しています。
GLM-5.3-Flash は、新たに訓練されたベースモデルを起点としており、そのアーキテクチャと訓練レシピは、能力と効率を軸に再設計されました。GLM シリーズでは初めて、スパースアテンションと線形アテンションを組み合わせたハイブリッドアーキテクチャを導入し、長文脈のサービングコストを大幅に削減しながら、正確な長文脈処理能力を維持しています。さらに、モデルはスケーリング効率をさらに高めるために Manifold-Constrained Hyper-Connections (mHC) を採用しています。これらに加えて、最新の 30T トークン のマルチモーダル事前学習コーパスを活用することで、GLM-5.3-Flash はより少ない計算リソースでより高い知能を実現します。
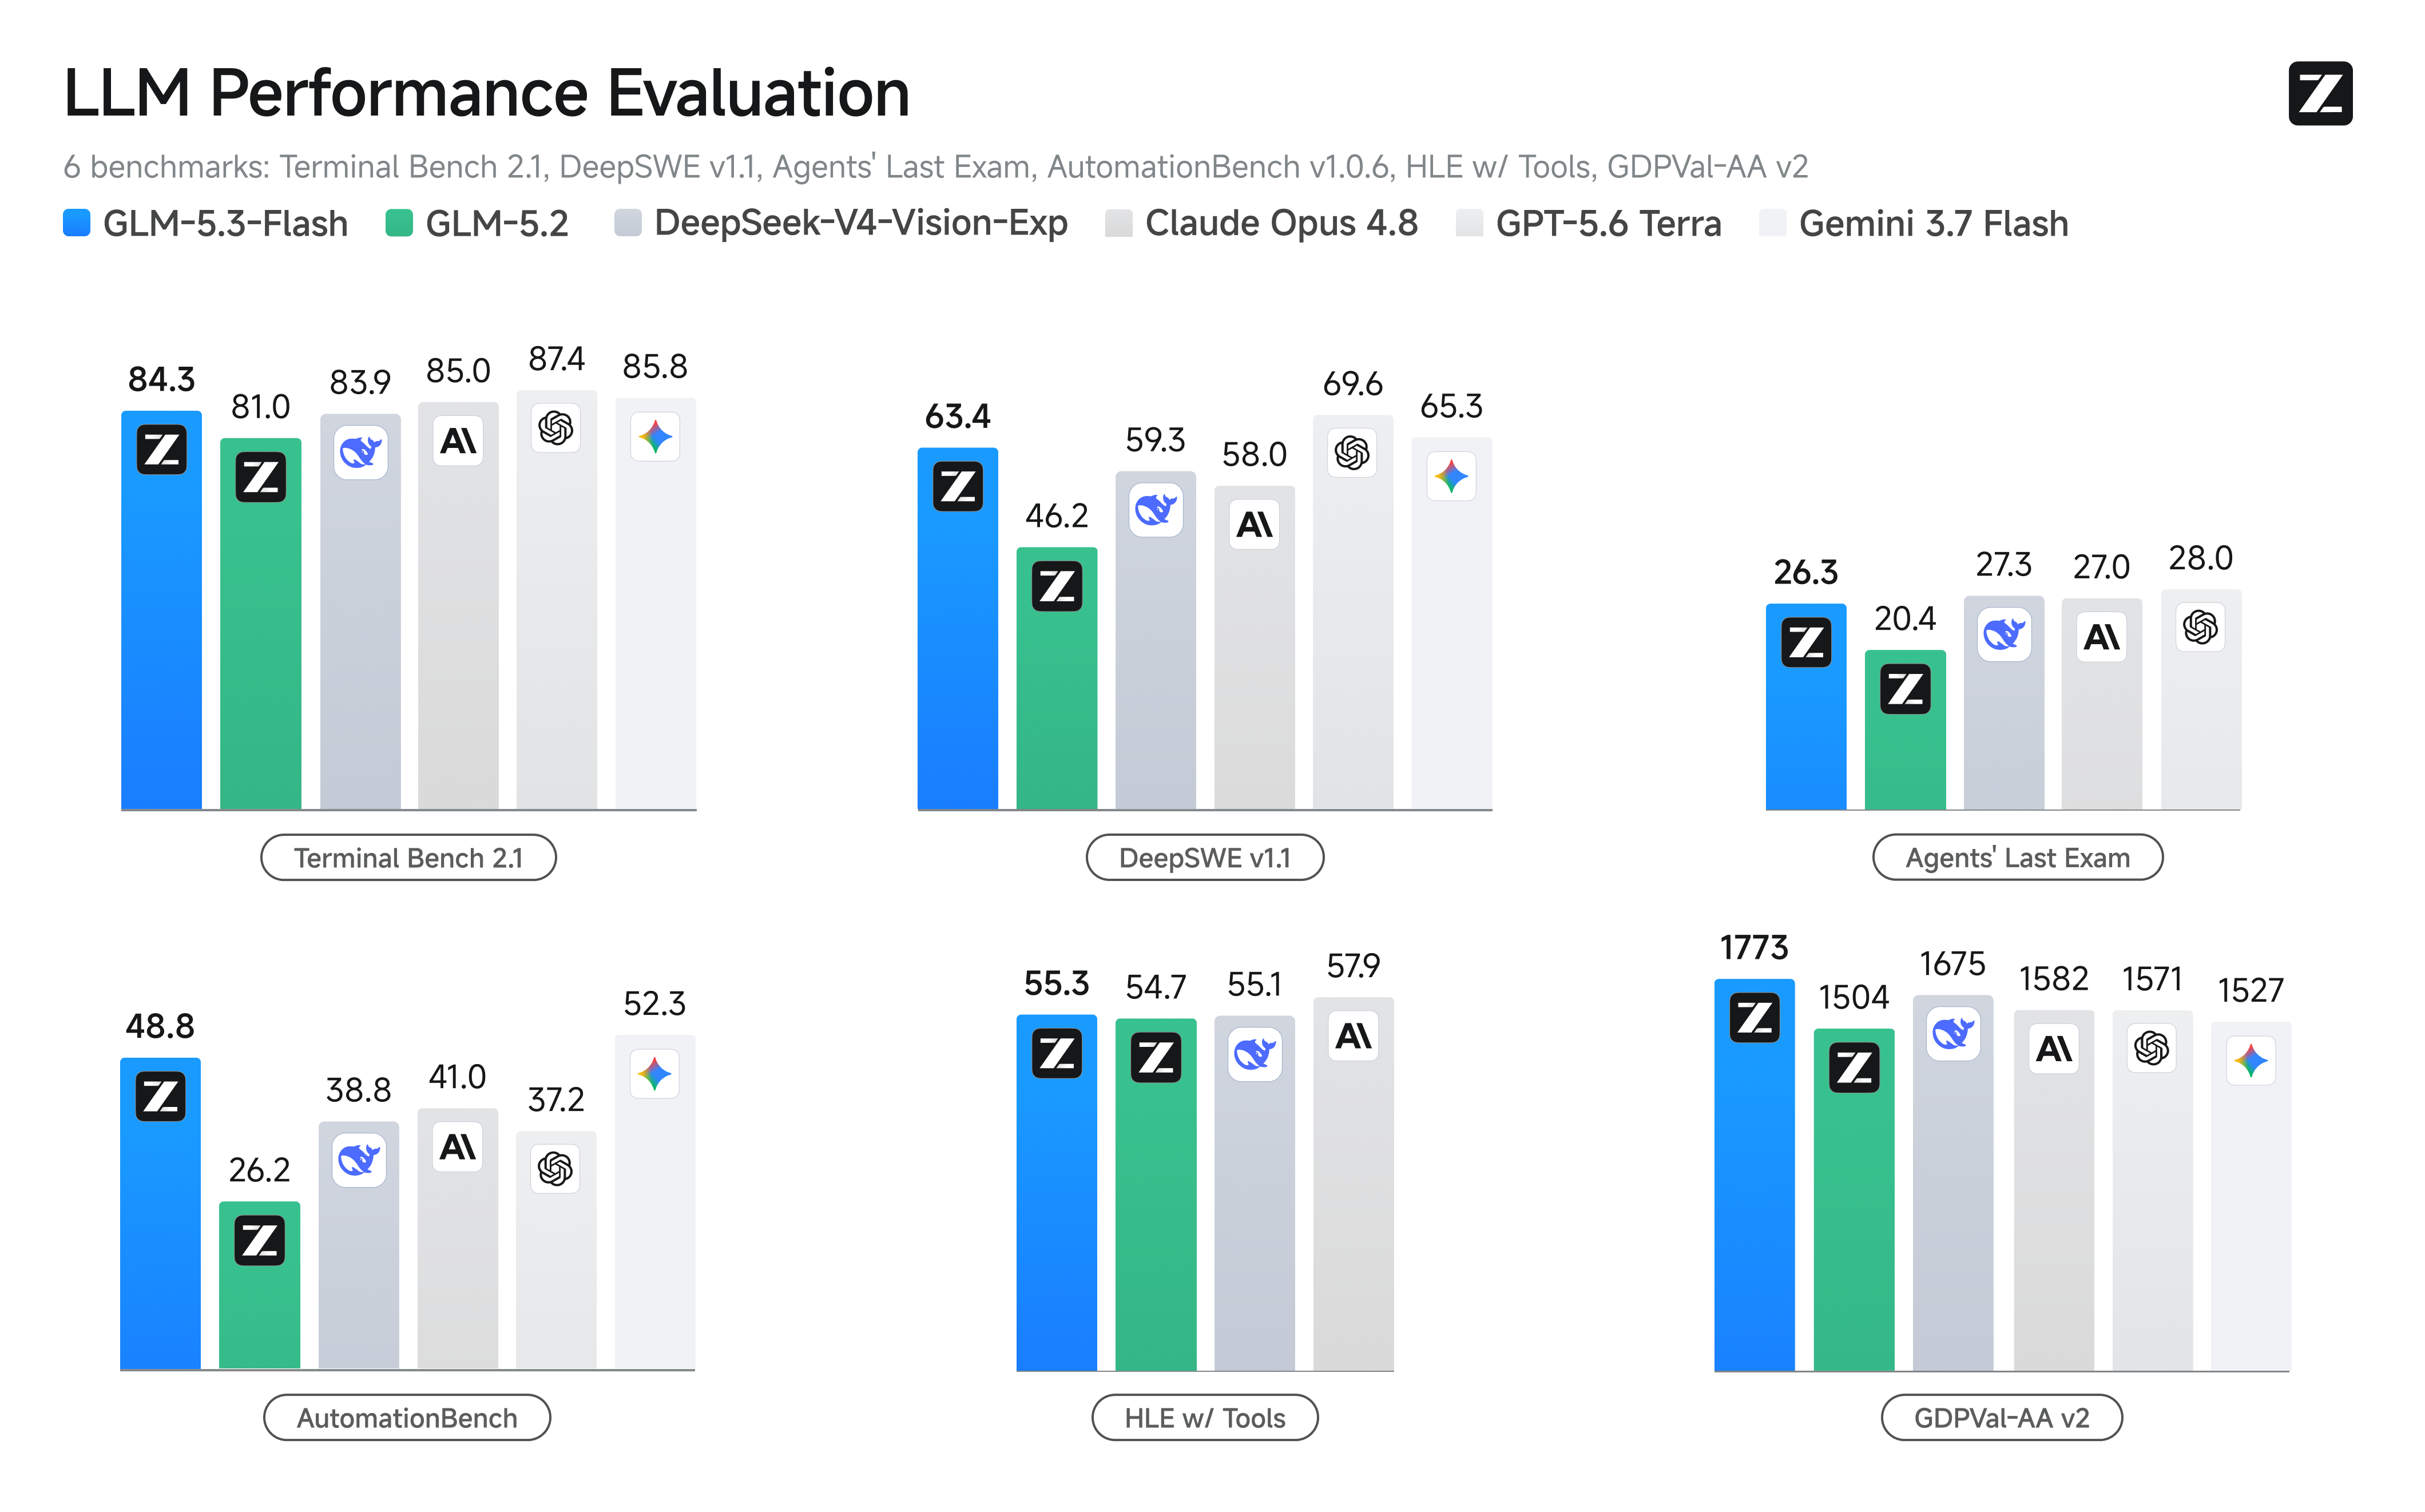
注記
- バッチ生成には左パディングを使用します。Padding sideを参照してください。
Glm5NextConfig
クラス transformers.Glm5NextConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonetext_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneimage_token_id: int = 154854video_token_id: int = 154855image_start_token_id: int = 154830image_end_token_id: int = 154831video_start_token_id: int = 154832video_end_token_id: int = 154833tie_word_embeddings: bool = False )
パラメータ
- text_config (
Union[dict, ~configuration_utils.PreTrainedConfig]、省略可) — テキストバックボーンの設定オブジェクトまたは辞書。 - vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig]、任意) — ビジョンバックボーンの config オブジェクトまたは辞書です。 - image_token_id (
int、任意、デフォルト値は 154854) — 画像プロンプトをエンコードするために使用する画像トークンのインデックスです。 - video_token_id (
int、任意、デフォルトは 154855) — 動画プロンプトをエンコードするための動画トークンのインデックスです。 - image_start_token_id (
int, 任意、デフォルトは 154830) — 画像の開始を示すトークンのインデックスです。 - image_end_token_id (
int, 任意、デフォルトは 154831) — 画像の終了をエンコードするための画像終了トークンのインデックスです。 - video_start_token_id (
int、任意、デフォルトは 154832) — 動画の開始をエンコードするための動画開始トークンのインデックスです。 - video_end_token_id (
int、任意、デフォルト値は 154833) — 動画の終了をエンコードするための動画終了トークンのインデックスです。 - tie_word_embeddings (
bool、任意、デフォルトはFalse) — モデルのtied_weights_keysマッピングに従って重み埋め込みを共有するかどうかを指定します。
これは Glm5NextModel の設定を保存するための設定クラスです。指定された引数に基づいて Glm5 Next モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、zai-org/GLM-5.3-Flash と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
Glm5NextTextConfig
クラス transformers.Glm5NextTextConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 154880hidden_size: int = 4096intermediate_size: int = 12288moe_intermediate_size: int = 2048num_hidden_layers: int = 45num_attention_heads: int = 64num_key_value_heads: int = 64n_shared_experts: int = 1n_routed_experts: int = 288output_router_logits: bool = Falserouted_scaling_factor: float = 2.5kv_lora_rank: int = 512q_lora_rank: int = 1536qk_rope_head_dim: int = 0v_head_dim: int = 256qk_nope_head_dim: int = 256n_group: int = 1topk_group: int = 1num_experts_per_tok: int = 8norm_topk_prob: bool = Truehidden_act: str = 'silu'max_position_embeddings: int = 1048576initializer_range: float = 0.02rms_norm_eps: float = 1e-05use_cache: bool = Truepad_token_id: int | None = 154820bos_token_id: int | None = Noneeos_token_id: int | list[int] | None = Nonetie_word_embeddings: bool = Falsemlp_layer_types: list[str] | None = Noneattention_bias: bool = Falseattention_dropout: float | int = 0.0index_topk: int = 2048index_head_dim: int = 128index_n_heads: int = 32head_dim: int = 0layer_types: list[str] | None = Noneindexer_types: list[str] | None = Noneswiglu_limit: float = 10.0linear_head_dim: int = 128linear_num_heads: int = 64linear_conv_kernel_dim: int = 4linear_lower_bound: float | None = -5.0hc_mult: int = 4hc_eps: float = 1e-06hc_sinkhorn_iters: int = 20router_aux_loss_coef: float = 0.001index_kpool: int = 16index_kpool_always_select_tail: bool = True )
パラメータ
- vocab_size (
int、任意、デフォルトは154880) — モデルの語彙サイズ。input_idsで表現できるトークンの種類数を定義します。 - hidden_size (
int、任意、デフォルトは4096) — 隠れ表現の次元数。 - intermediate_size (
int、任意、デフォルトは12288) — MLP 表現の次元数。 - moe_intermediate_size (
int、任意、デフォルトは2048) — ルーティングされたエキスパートのMLPの中間サイズ。 - num_hidden_layers (
int、任意、デフォルトは45) — Transformer デコーダーの隠れ層の数。 - num_attention_heads (
int、任意、デフォルトは64) — Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。 - num_key_value_heads (
int、任意、デフォルトは64) — Grouped Query Attention を実装するために使用する key_value ヘッドの数です。num_key_value_heads=num_attention_headsの場合、モデルは Multi Head Attention (MHA) を使用し、num_key_value_heads=1の場合は Multi Query Attention (MQA) を使用し、それ以外の場合は GQA が使用されます。 マルチヘッドのチェックポイントを GQA のチェックポイントに変換する際は、各グループの key と value ヘッドを、そのグループ内の元のすべてのヘッドの平均プーリングによって構築する必要があります。詳細については、この論文を参照してください。指定されない場合、デフォルトでnum_attention_headsが使用されます。 - n_shared_experts (
int、任意、デフォルトは1) — 共有エキスパートの数。 - n_routed_experts (
int、任意、デフォルトは288) — ルーティング対象のエキスパートの数。 - output_router_logits (
bool、任意、デフォルトはFalse) — モデルがルーターのロジツを返すかどうかを指定します。これを有効にすると、モデルは補助損失(ロードバランシング損失とルーターのz損失を含む)を出力できるようになります。 - routed_scaling_factor (
float、任意、デフォルトは2.5) — ルーティングされたエキスパートのスケール係数。 - kv_lora_rank (
int、任意、デフォルトは512) — キーおよびバリューの射影に使用される LoRA 行列のランクです。 - q_lora_rank (
int、任意、デフォルトは1536) — クエリ投影用の LoRA 行列のランクです。 - qk_rope_head_dim (
int、任意、デフォルトは0) — 回転位置埋め込みを使用するクエリ/キーヘッドの次元数。 - v_head_dim (
int、任意、デフォルトは256) — バリューヘッドの次元数。 - qk_nope_head_dim (
int、任意、デフォルトは256) — 回転位置埋め込みを使用しないクエリ/キーヘッドの次元数。 - n_group (
int、任意、デフォルトは 1)— ルーティング対象のエクスパートグループの数。 - topk_group (
int、任意、デフォルトは1) — 各トークンについて選択されるグループの数(各トークンにおいて、選択されるエキスパートがtopk_group個のグループ内にのみ含まれることを保証します)。 - num_experts_per_tok (
int、任意、デフォルトは8) — 各トークンをルーティングするエキスパートの数です。これは、トークン選択ルーティングにおける top-k の値です。 - norm_topk_prob (
bool、任意、デフォルトはTrue) — ルーティングされたエキスパートの重みを正規化するかどうかを指定します。 - hidden_act (
str、任意、デフォルトはsilu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - max_position_embeddings (
int、任意、デフォルトは1048576) — このモデルが使用される可能性のある最大シーケンス長です。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - rms_norm_eps (
float、任意、デフォルト値は1e-05) — RMS正規化レイヤーで使用するepsilonです。 - use_cache (
bool、任意、デフォルトはTrue) — モデルが最後のキー/バリューの注意を返すかどうか(すべてのモデルで利用されるわけではありません)。config.is_decoder=Trueの場合、またはモデルがデコーダー専用の生成モデルである場合にのみ関連します。 - pad_token_id (
int、任意、デフォルトは154820) — 語彙内でパディングに使用されるトークン ID。 - bos_token_id (
int, 省略可) — 語彙におけるストリーム開始に使用されるトークン ID。 - eos_token_id (
Union[int, list[int]], 省略可) — 語彙内でストリーム終了に使用されるトークン ID。 - tie_word_embeddings (
bool、任意、デフォルトはFalse) — モデルのtied_weights_keysマッピングに従って重み埋め込みを共有するかどうかを指定します。 - mlp_layer_types (
list[str]、省略可) — レイヤーごとのフィードフォワードスケジュール。値は"dense"または"sparse"です。 - attention_bias (
bool、任意、デフォルトはFalse) — 自己注意機構において、クエリ、キー、バリュー、出力の投影層にバイアスを使用するかどうかを指定します。 - attention_dropout (
Union[float, int]、任意、デフォルトは0.0) — アテンション確率のドロップアウト率です。 - index_topk (
int、省略可、デフォルトは 2048) — DSA インデクサーによって選択されるスパースアテンションの位置数。 - index_head_dim (
int、任意、デフォルトは 128) — DSA インデクサーの投影ヘッド次元数。 - index_n_heads (
int、任意、デフォルトは 32)— DSA インデクサーのヘッド数。 - head_dim (
int、任意、デフォルトは0) — アテンションヘッドの次元です。None の場合、hidden_size // num_attention_heads がデフォルトとして使用されます。 - layer_types (
list[str]、省略可) — レイヤーごとのアテンションキャッシュスケジュール。KDA レイヤーには"linear_attention"、MLA (DSA) レイヤーには"indexed_attention"を指定します。 - indexer_types (
list[str]、省略可) — レイヤーごとの DSA インデクサーモード。値は"full"(インデクサーを実行)または"shared"(直前の full レイヤーの top-k 選択を再利用)です。 - swiglu_limit (
float、任意、デフォルトは 10.0) — SwiGLU の gate/up 投影に適用されるクランプの上限値。 - linear_head_dim (
int、任意、デフォルトは 128) — linear attention における各 head の次元数。 - linear_num_heads (
int、任意、デフォルトは 64)— 線形アテンション層で使用するヘッド数。 - linear_conv_kernel_dim (
int、任意、デフォルト値は 4) — 線形アテンション層で使用する畳み込みのカーネルサイズ。 - linear_lower_bound (
float、任意、デフォルト値は -5.0) — forget gate に適用される減衰の下限値を設定するかどうか。 - hc_mult (
int、任意、デフォルトは 4) — MHC 残差ストリームの数。 - hc_eps (
float、任意、デフォルト値は 1e-6) — MHC Sinkhorn 正規化で使用する数値的な下限値。 - hc_sinkhorn_iters (
int、任意、デフォルト値は 20)— MHC ルーティングで使用する Sinkhorn 反復の回数です。 - router_aux_loss_coef (
float、任意、デフォルト値は0.001) — 補助的なロードバランシング損失の係数です。MoEモデルにおける不均一なエキスパートルーティングをペナルティするために使用されます。 - index_kpool (
int、省略可能、デフォルト値は 16)— DSA インデクサーによって選択される圧縮トークングループのプールサイズです。 - index_kpool_always_select_tail (
bool、任意、デフォルトはTrue) — 不完全な KPool の末尾が、スパースアテンションに常に含まれるかどうかを指定します。
これは Glm5NextModel の設定を保存するための設定クラスです。指定された引数に基づいて Glm5 Next モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、zai-org/GLM-5.3-Flash と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
Glm5NextVisionConfig
class transformers.Glm5NextVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonedepth: int = 24hidden_size: int = 1024hidden_act: str = 'silu'attention_bias: bool = Trueattention_dropout: float | int = 0.0num_heads: int = 16in_channels: int = 3image_size: int | list[int] | tuple[int, int] = 336patch_size: int | list[int] | tuple[int, int] = 14rms_norm_eps: float = 1e-05spatial_merge_size: int = 2temporal_patch_size: int | list[int] | tuple[int, int] = 2out_hidden_size: int = 1536intermediate_size: int = 4096initializer_range: float = 0.02rope_parameters: dict | None = Noneprojection_intermediate_size: int = 10240swiglu_limit: float = 10.0 )
パラメータ
- depth (
int、任意、デフォルトは24) — ビジョンエンコーダーの Transformer レイヤー数。 - hidden_size (
int、任意、デフォルトは1024) — 隠れ表現の次元数。 - hidden_act (
str、任意、デフォルトはsilu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - attention_bias (
bool、任意、デフォルトはTrue) — 自己注意機構において、クエリ、キー、バリュー、および出力の投影層にバイアスを使用するかどうかを指定します。 - attention_dropout (
Union[float, int]、任意、デフォルトは0.0) — アテンション確率のドロップアウト率です。 - num_heads (
int、任意、デフォルトは16) — Transformerデコーダーの各アテンション層におけるアテンションヘッドの数。 - in_channels (
int、任意、デフォルトは3) — 入力チャネル数。 - image_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは336) — 各画像のサイズ(解像度)です。 - patch_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは14) — 各パッチのサイズ(解像度)です。 - rms_norm_eps (
float、任意、デフォルト値は1e-05) — RMS正規化レイヤーで使用するepsilonです。 - spatial_merge_size (
int, 省略可、デフォルトは2) — 隣接するパッチをマージしてビジュアルトークンの数を削減するために使用される、空間マージウィンドウのサイズです。 - temporal_patch_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは2) — 動画入力における3Dパッチ埋め込みで使用する時間方向のパッチサイズ。 - out_hidden_size (
int、任意、デフォルトは 1536) — ビジョンモデルの出力隠れ層サイズです。 - intermediate_size (
int、任意、デフォルトは4096) — MLP 表現の次元数。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - rope_parameters (
dict, 任意) — RoPE 埋め込みの設定パラメータを含む辞書です。辞書にはrope_thetaの値が含まれており、より長いmax_position_embeddingsで RoPE を使用する場合、スケーリングに使用されるパラメータが任意で含まれます。 - projection_intermediate_size (
int、任意、デフォルトは 10240)— vision patch merger 用の projection_intermediate_size サイズです。 - swiglu_limit (
float、任意、デフォルトは 10.0) — ビジョン SwiGLU の gate/up 投影に適用されるクランプの上限値。
これは Glm5NextModel の設定を保存するための設定クラスです。指定された引数に基づいて Glm5 Next モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、zai-org/GLM-5.3-Flash と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
Glm5NextPreTrainedModel
クラス transformers.Glm5NextPreTrainedModel
< source >( config: PreTrainedConfig*inputs**kwargs )
パラメータ
- config (PreTrainedConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
Glm5NextTextModel
クラス transformers.Glm5NextTextModel
< source >( config: Glm5NextTextConfig )
パラメータ
- config (Glm5NextTextConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
Glm5 Next Text Modelの生モデルで、特定のヘッドを上に載せず、生のhidden-statesを出力します。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeModelOutputWithPast or tuple(torch.Tensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - inputs_embeds (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。
戻り値
MoeModelOutputWithPast または tuple(torch.Tensor)
MoeModelOutputWithPast または、torch.Tensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)。構成(Glm5NextConfig)や入力に応じて、さまざまな要素で構成されます。
Glm5NextTextModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。past_key_values (
Cache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — Cache のインスタンスです。詳細については、kv cache ガイドを参照してください。自己アテンションブロック(および
config.is_encoder_decoder=Trueの場合、クロスカレンションブロック)の事前計算済みヒドゥンステート(キーとバリュー)を保持します。これらは逐次デコーディングを高速化するために使用できます(past_key_values入力参照)。hidden_states (
tuple(torch.Tensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.Tensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.Tensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.Tensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
router_logits (
tuple(torch.Tensor)、optional、output_router_probs=Trueとconfig.add_router_probs=Trueが渡された場合、またはconfig.output_router_probs=Trueの場合に返されます) — 各層に対応するtorch.Tensorのタプルで、形状は(batch_size, sequence_length, num_experts)です。MoE ルーターによって計算される生(raw)のルーター logits(softmax 適用後)であり、Mixture of Experts モデルの補助損失を計算するためにこれらの用語が使用されます。
Glm5NextModel
Glm5NextVisionModel
クラス transformers.Glm5NextVisionModel
< source >( config: Glm5NextVisionConfig )
パラメータ
- config (Glm5NextVisionConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連付けられた重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
…
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( hidden_states: Tensorgrid_thw: Tensor**kwargs ) → torch.Tensor
Glm5NextVisionModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
クラス transformers.Glm5NextModel
< source >( config: Glm5NextConfig )
パラメータ
- config (Glm5NextConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
…
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Nonepixel_values: typing.Optional[torch.Tensor] = Nonepixel_values_videos: typing.Optional[torch.Tensor] = Noneimage_grid_thw: typing.Optional[torch.LongTensor] = Nonevideo_grid_thw: typing.Optional[torch.LongTensor] = Nonemm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPast or tuple(torch.Tensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - inputs_embeds (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。 - pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は Glm5NextImageProcessor を使用して取得できます。詳細については Glm5NextImageProcessor.call() を参照してください(Glm5NextProcessor は画像の処理に Glm5NextImageProcessor を使用します)。 - pixel_values_videos (
torch.Tensor、形状(batch_size, num_frames, num_channels, frame_size, frame_size)、任意) — 入力動画に対応するテンソルです。動画のピクセル値は、Glm5NextVideoProcessor を使用して取得できます。詳細については、Glm5NextVideoProcessor.call() を参照してください(Glm5NextProcessor は動画の処理に Glm5NextVideoProcessor を使用します)。 - image_grid_thw (
torch.LongTensor、形状(num_images, 3)、任意) — LLM における各画像のフィーチャー形状の時間軸、高さ、幅です。 - video_grid_thw (
torch.LongTensor、形状(num_videos, 3)、任意) — LLM における各動画のフィーチャー形状の時間軸、高さ、幅です。 - mm_encoder_outputs (
dict[str, ~modeling_outputs.BaseModelOutputWithPooling], 省略可) — キーがサポートされているモダリティ、値がそのモダリティのエンコード済み出力である辞書。各エンコード済み出力は、(pooler_output, 省略可:last_hidden_states, 省略可:hidden_states, 省略可:attentions)pooler_output(形状(batch_size, sequence_length, hidden_size), 省略可) からなるタプルです。pooler_outputは、エンコーダーのマルチモーダル特徴量をテキスト埋め込みにマージしたシーケンスです。
戻り値
BaseModelOutputWithPast または tuple(torch.Tensor)
torch.Tensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)または BaseModelOutputWithPast。設定(Glm5NextConfig)と入力に応じて、さまざまな要素で構成されます。
Glm5NextModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。past_key_valuesが使用されている場合、出力されるのは、形状(batch_size, 1, hidden_size)のシーケンスの最後の隠れ状態のみです。past_key_values (
Cache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — Cache のインスタンスです。詳細については、kv cache ガイドを参照してください。自己アテンションブロック(および
config.is_encoder_decoder=Trueの場合、クロスカレンションブロック)の事前計算済みヒドゥンステート(キーとバリュー)を保持します。これらは逐次デコーディングを高速化するために使用できます(past_key_values入力参照)。hidden_states (
tuple(torch.Tensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.Tensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.Tensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.Tensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
Glm5NextForConditionalGeneration
クラス transformers.Glm5NextForConditionalGeneration
< source >( config: Glm5NextConfig )
パラメータ
- config (Glm5NextConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
他のモダリティ(例:画像とテキストからテキストを生成する)に条件付けられたトークン生成用の Glm5 Next Model。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Nonepixel_values: typing.Optional[torch.Tensor] = Nonepixel_values_videos: typing.Optional[torch.Tensor] = Noneimage_grid_thw: typing.Optional[torch.LongTensor] = Nonevideo_grid_thw: typing.Optional[torch.LongTensor] = Noneoutput_router_logits: bool | None = Nonemm_token_type_ids: typing.Optional[torch.IntTensor] = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeCausalLMOutputWithPast or tuple(torch.Tensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - inputs_embeds (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - labels (
torch.LongTensor、shape(batch_size, sequence_length)、任意) — マスク言語モデリング損失を計算するためのラベルです。インデックスは[0, ..., config.vocab_size]の範囲内であるか、-100 である必要があります(input_idsの docstring を参照)。インデックスが-100に設定されたトークンは無視(マスク)され、損失は[0, ..., config.vocab_size]の範囲内のラベルを持つトークンに対してのみ計算されます。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。 - pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は Glm5NextImageProcessor を使用して取得できます。詳細については Glm5NextImageProcessor.call() を参照してください(Glm5NextProcessor は画像の処理に Glm5NextImageProcessor を使用します)。 - pixel_values_videos (
torch.Tensor、形状(batch_size, num_frames, num_channels, frame_size, frame_size)、任意) — 入力動画に対応するテンソルです。動画のピクセル値は、Glm5NextVideoProcessor を使用して取得できます。詳細については、Glm5NextVideoProcessor.call() を参照してください(Glm5NextProcessor は動画の処理に Glm5NextVideoProcessor を使用します)。 - image_grid_thw (
torch.LongTensor、形状(num_images, 3)、任意) — LLM における各画像のフィーチャー形状の時間軸、高さ、幅です。 - video_grid_thw (
torch.LongTensor、形状(num_videos, 3)、任意) — LLM における各動画のフィーチャー形状の時間軸、高さ、幅です。 - output_router_logits (
bool, 省略可) — すべてのルーターの logits を返すかどうか。ルーター損失の計算に有用ですが、推論時には返すべきではありません。 - mm_token_type_ids (
torch.IntTensor、形状(batch_size, sequence_length)、任意) — 各モダリティに一致する入力シーケンスのトークンインデックスです。例えば、テキスト (0)、画像 (1)、動画 (2) などです。マルチモーダルなトークンタイプIDは、AutoProcessor を使用して取得できます。詳細は ProcessorMixin.call() を参照してください。 - logits_to_keep (
Union[int, torch.Tensor]、省略可、デフォルトは0) —intの場合、最後のlogits_to_keepトークンについて logits を計算します。0の場合、すべてのinput_idsについて logits を計算します(特殊ケース)。生成には最後のトークンの logits だけで十分であり、そのトークンのみについて計算することでメモリを節約できます。これは、長いシーケンスや大規模な語彙サイズの場合に特に顕著な効果があります。torch.Tensorの場合、シーケンス長次元で保持するインデックスに対応する 1 次元テンソルである必要があります。これは、パックされたテンソル形式(バッチとシーケンス長を単一の次元にまとめた形式)を使用する場合に有用です。 - mm_encoder_outputs (
dict[str, ~modeling_outputs.BaseModelOutputWithPooling], 省略可) — キーがサポートされているモダリティ、値がそのモダリティのエンコード済み出力である辞書。各エンコード済み出力は、(pooler_output, 省略可:last_hidden_states, 省略可:hidden_states, 省略可:attentions)pooler_output(形状(batch_size, sequence_length, hidden_size), 省略可) からなるタプルです。pooler_outputは、エンコーダーのマルチモーダル特徴量をテキスト埋め込みにマージしたシーケンスです。
戻り値
MoeCausalLMOutputWithPast または tuple(torch.Tensor)
MoeCausalLMOutputWithPast、またはtorch.Tensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)。設定(Glm5NextConfig)や入力に応じて、さまざまな要素で構成されます。
Glm5NextForConditionalGenerationのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.Tensor、形状(1,)、任意、labelsが指定された場合に返されます) — 言語モデリングの損失(次のトークンの予測用)。logits (
torch.Tensor、形状(batch_size, sequence_length, config.vocab_size)) — 言語モデリングヘッドの予測スコア(SoftMax 適用前の各語彙トークンのスコア)。aux_loss (
torch.Tensor、任意、output_router_logits=Trueが渡された場合、またはconfig.output_router_logits=Trueかつモデルがロードバランシング損失でルーターを学習する場合に返されます) — スパースモジュールのロードバランシング補助損失。ルーターバイアスでエキスパートをバランスさせるモデル(DeepSeek-V3 とそこから派生したアーキテクチャ)は、router_logitsを返しながらも、ここではNoneを返します。router_logits (
tuple(torch.Tensor)、optional、output_router_logits=Trueが渡された場合またはconfig.output_router_logits=Trueの場合に返されます) —torch.Tensorのタプル(スパース層ごとに1つ)、形状は(batch_size * sequence_length, num_experts)。MoEルーターによって計算される生のルーターロジットです。ロードバランシング損失の計算や、トークンがどのようにエキスパートにディスパッチされるかの確認に使用できます。
past_key_values (
Cache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — Cache のインスタンスです。詳細については、kv cache ガイドを参照してください。逐次デコーディングを高速化するために使用できる(
past_key_values入力参照)、事前計算済みの隠れ状態(自己注意ブロックのキーとバリュー)が含まれます。hidden_states (
tuple(torch.Tensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.Tensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.Tensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.Tensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoProcessor, Glm5NextForConditionalGeneration
>>> import torch

>>> model = Glm5NextForConditionalGeneration.from_pretrained("zai-org/GLM-5.3-Flash")
>>> processor = AutoProcessor.from_pretrained("zai-org/GLM-5.3-Flash")

>>> messages = [
...     {
...         "role": "user",
...         "content": [
...             {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
...             {"type": "text", "text": "Describe the image."},
...         ],
...     }
... ]
>>> inputs = processor.apply_chat_template(
...     messages, tokenize=True, add_generation_prompt=True, return_dict=True, return_tensors="pt"
... )
>>> inputs = {k: v.to(model.device) if isinstance(v, torch.Tensor) else v for k, v in inputs.items()}
>>> generated_ids = model.generate(**inputs, max_new_tokens=64)
Glm5NextProcessor
class transformers.Glm5NextProcessor
< source >( image_processor = Nonetokenizer = Nonevideo_processor = Nonechat_template = None**kwargs )
画像プロセッサ、トークナイザー、および動画プロセッサを単一のプロセッサにラップするGlm5NextProcessorを構築します。
Glm5NextProcessor は、Glm5NextImageProcessor、tokenizer_class、および Glm5NextVideoProcessor のすべての機能を提供します。詳細については、~Glm5NextImageProcessor、~tokenizer_class、および ~Glm5NextVideoProcessor を参照してください。
post_process_image_text_to_text
< source >( generated_outputsskip_special_tokens = Trueclean_up_tokenization_spaces = False**kwargs ) → list[str]
パラメータ
- generated_outputs (
torch.Tensorまたはnp.ndarray) — モデルのgenerate関数の出力です。出力は、(batch_size, sequence_length)または(sequence_length,)の形状のテンソルであることが期待されます。 - skip_special_tokens (
bool、省略可、デフォルトはTrue) — 出力から特殊トークンを除去するかどうか。トークナイザーのbatch_decodeメソッドに渡される引数です。 - clean_up_tokenization_spaces (
bool、任意、デフォルトはFalse) — トークン化のスペースを整理するかどうか。トークナイザーのbatch_decodeメソッドに渡される引数です。 - **kwargs —
batch_decode methodに渡す追加の引数。
戻り値
list[str]
デコードされたテキスト。
モデルの出力を後処理して、テキストをデコードします。
Glm5NextImageProcessor
クラス transformers.Glm5NextImageProcessor
< source >( **kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、optional、デフォルトはTrue) — 画像を RGB に変換するかどうか。 - do_resize (
bool、kwargs、任意、デフォルトはTrue) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs、デフォルトは{'longest_edge' -- 1}): モデルへの入力サイズの最大値を指定します。 - default_to_square (
bool、kwargs、任意、デフォルトはFalse) — size が整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs、デフォルトは3) — 画像のリサイズ時に使用するリサンプリングフィルタです。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ、効果が現れます。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool、kwargs、optional、デフォルトはTrue) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルトは[0.48145466, 0.4578275, 0.40821073]) — 正規化に使用する画像の平均値です。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional, デフォルト値は[0.26862954, 0.26130258, 0.27577711]) — 正規化に使用する画像の標準偏差です。do_normalizeがTrueに設定されている場合のみ、効果が現れます。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - Returns が
'pt'に設定されている場合はスタックされたテンソルを、それ以外の場合はテンソルのリストを返します。 —
Glm5NextImageProcessor 画像プロセッサを構築します。
disable_grouping (bool, kwargs, optional):
サイズによる画像のグループ化を無効にし、バッチ処理ではなく個別に処理するかどうかを指定します。
None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (int, kwargs, optional):
入力内の各画像に使用される画像トークンの数です。
後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
get_number_of_image_patches
< source >( height: intwidth: intimages_kwargs: dict | None = None ) → int
指定された画像サイズに対する画像パッチの数を返すユーティリティです。
seq_len、patch_dim の形状のフラットなレイアウトに各画像をパッチ化し、動的な形状を持つピクセルを連結できるようにします。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]**kwargs: *<class 'transformers.models.glm5_next.image_processing_glm5_next.Glm5NextImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - patch_size (
int、kwargs、任意、デフォルト値は 14) — ビジョンエンコーダーの空間パッチサイズです。 - temporal_patch_size (
int、kwargs、任意、デフォルト値は 2)— ビジョンエンコーダーの時間方向のパッチサイズです。 - merge_size (
int, kwargs, 任意, デフォルト値は 2) — ビジョンエンコーダから LLM エンコーダへのマージサイズです。 - patch_expand_factor (
int、kwargs、任意、デフォルト値は 1)— ビジョンエンコーダーから LLM エンコーダーへの patch_expand_factor です。 - min_image_tokens (
int, kwargs) — 1枚の画像あたりの最小トークン数です。 - max_image_tokens (
int, kwargs) — 1枚の画像あたりの最大トークン数。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
リサイズ
< source >( images: torch.Tensorresample: PILImageResampling | tvF.InterpolationMode | int | Nonefactor: inttemporal_factor: intmin_image_tokens: intmax_image_tokens: int**kwargs )
入力画像のアスペクト比に基づいて動的にリサイズします。
Glm5NextImageProcessorPil
class transformers.Glm5NextImageProcessorPil
< source >( **kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、optional、デフォルトはTrue) — 画像を RGB に変換するかどうか。 - do_resize (
bool、kwargs、任意、デフォルトはTrue) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs、デフォルトは{'longest_edge' -- 1}): モデルへの入力サイズの最大値を指定します。 - default_to_square (
bool、kwargs、任意、デフォルトはFalse) — size が整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs、デフォルトは3) — 画像のリサイズ時に使用するリサンプリングフィルタです。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ、効果が現れます。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool、kwargs、optional、デフォルトはTrue) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルトは[0.48145466, 0.4578275, 0.40821073]) — 正規化に使用する画像の平均値です。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional, デフォルト値は[0.26862954, 0.26130258, 0.27577711]) — 正規化に使用する画像の標準偏差です。do_normalizeがTrueに設定されている場合のみ、効果が現れます。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - Returns が
'pt'に設定されている場合はスタックされたテンソルを、それ以外の場合はテンソルのリストを返します。 —
Glm5NextImageProcessor 画像プロセッサを構築します。
disable_grouping (bool, kwargs, optional):
サイズによる画像のグループ化を無効にし、バッチ処理ではなく個別に処理するかどうかを指定します。
None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (int, kwargs, optional):
入力内の各画像に使用される画像トークンの数です。
後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
get_number_of_image_patches
< source >( height: intwidth: intimages_kwargs: dict | None = None ) → int
指定された画像サイズに対する画像パッチの数を返すユーティリティです。
seq_len、patch_dim の形状のフラットなレイアウトに各画像をパッチ化し、動的な形状を持つピクセルを連結できるようにします。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]**kwargs: *<class 'transformers.models.glm5_next.image_processing_pil_glm5_next.Glm5NextImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - patch_size (
int、kwargs、任意、デフォルト値は 14) — ビジョンエンコーダーの空間パッチサイズです。 - temporal_patch_size (
int、kwargs、任意、デフォルト値は 2)— ビジョンエンコーダーの時間方向のパッチサイズです。 - merge_size (
int, kwargs, 任意, デフォルト値は 2) — ビジョンエンコーダから LLM エンコーダへのマージサイズです。 - patch_expand_factor (
int、kwargs、任意、デフォルト値は 1)— ビジョンエンコーダーから LLM エンコーダーへの patch_expand_factor です。 - min_image_tokens (
int, kwargs) — 1枚の画像あたりの最小トークン数です。 - max_image_tokens (
int, kwargs) — 1枚の画像あたりの最大トークン数。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
リサイズ
< source >( image: ndarrayresample: PILImageResampling | int | Nonefactor: inttemporal_factor: intmin_image_tokens: intmax_image_tokens: int**kwargs )
入力画像のアスペクト比に基づいて動的にリサイズします。
Glm5NextVideoProcessor
class transformers.Glm5NextVideoProcessor
< source >( **kwargs: *<class 'transformers.models.glm5_next.video_processing_glm5_next.Glm5NextVideoProcessorInitKwargs'> )
Glm5NextVideoProcessorの動画プロセッサを構築します。
get_num_of_video_patches
< source >( num_frames: intheight: intwidth: intvideos_kwargs = None ) → int
指定された動画サイズに対する動画パッチの数を返すユーティリティです。
各動画を(seq_len, patch_dim)の形状のフラットなレイアウトにパッチ化し、動的な形状のピクセルを連結できるようにします。
リサイズ
< source >( videos: torch.Tensorresample: PILImageResampling | tvF.InterpolationMode | int | Nonefactor: inttemporal_factor: intmin_image_tokens: intmax_image_tokens: int**kwargs )
入力動画のアスペクト比に基づいて動的にリサイズします。
sample_frames
< source >( metadata: VideoMetadatafps: int | float | None = None**kwargs ) → np.ndarray