
Hub documentation
استخدام نماذج الذكاء الاصطناعي محلياً
استخدام نماذج الذكاء الاصطناعي محلياً
يمكنك تشغيل نماذج الذكاء الاصطناعي من Hub محليًا على جهازك. وهذا يعني أنك يمكنك الاستفادة من هذه المزايا:
- الخصوصية: لن يتم إرسال بياناتك إلى خادم بعيد.
- السرعة: العتاد هو العامل المحدد، وليس سرعة الخادم أو الاتصال.
- التحكم: يمكنك تكوين النماذج كما تشاء.
- التكلفة: يمكنك تشغيل النماذج محليًا دون دفع رسوم لمزود واجهة برمجة التطبيقات.
كيفية استخدام التطبيقات المحلية
التطبيقات المحلية هي تطبيقات يمكنها تشغيل نماذج Hugging Face مباشرةً على جهازك. للبدء:
- تفعيل التطبيقات المحلية في إعدادات التطبيقات المحلية.
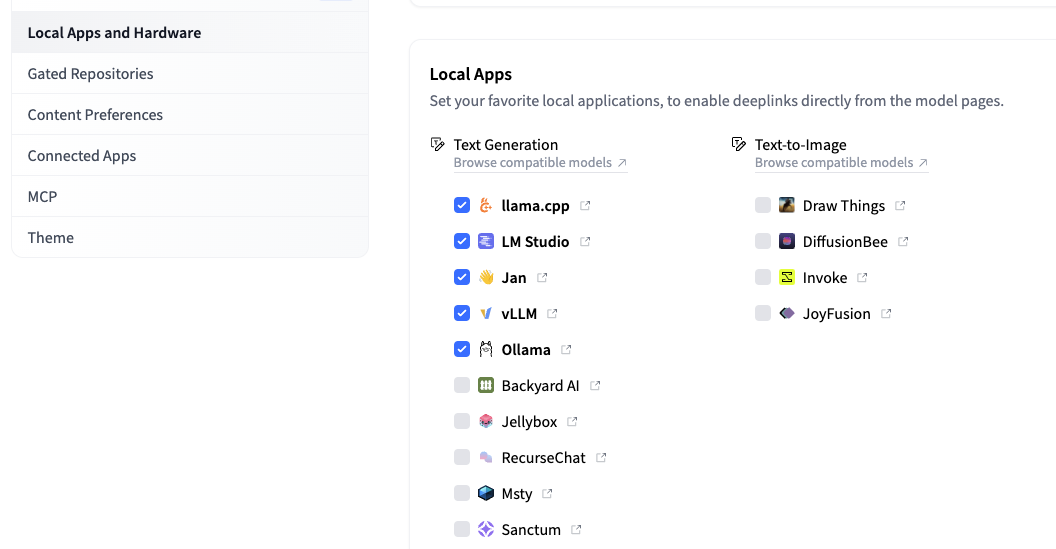
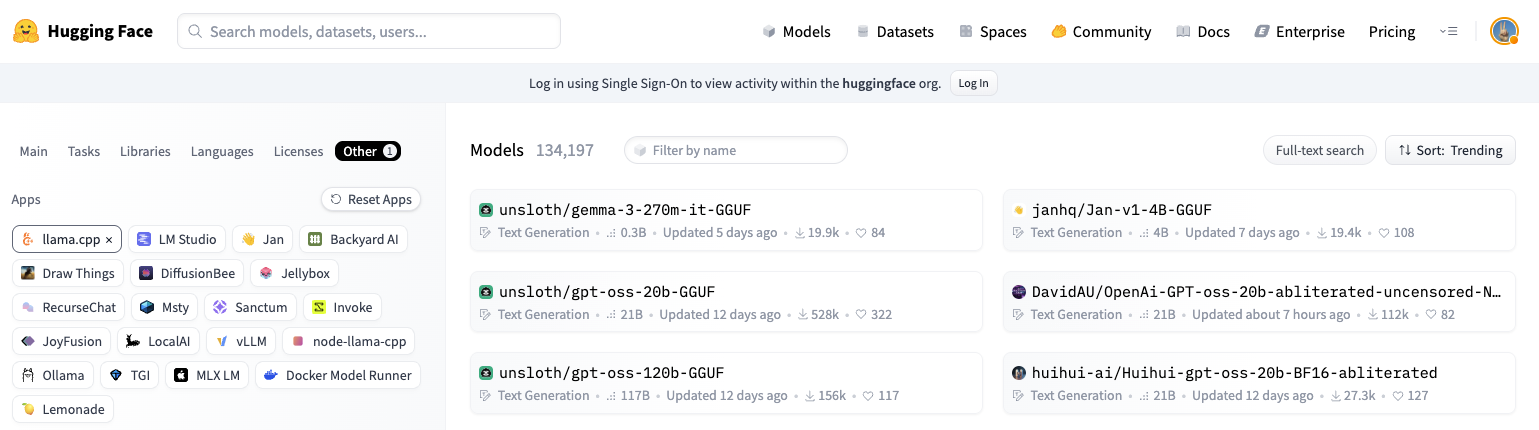
- اختر نموذجًا مدعومًا من Hub عن طريق البحث عنه. يمكنك التصفية حسب التطبيق في مجموعة
Appsضمن قسمOtherفي شريط التصفية الجانبي، على سبيل المثال النماذج المتوافقة مع llama.cpp:
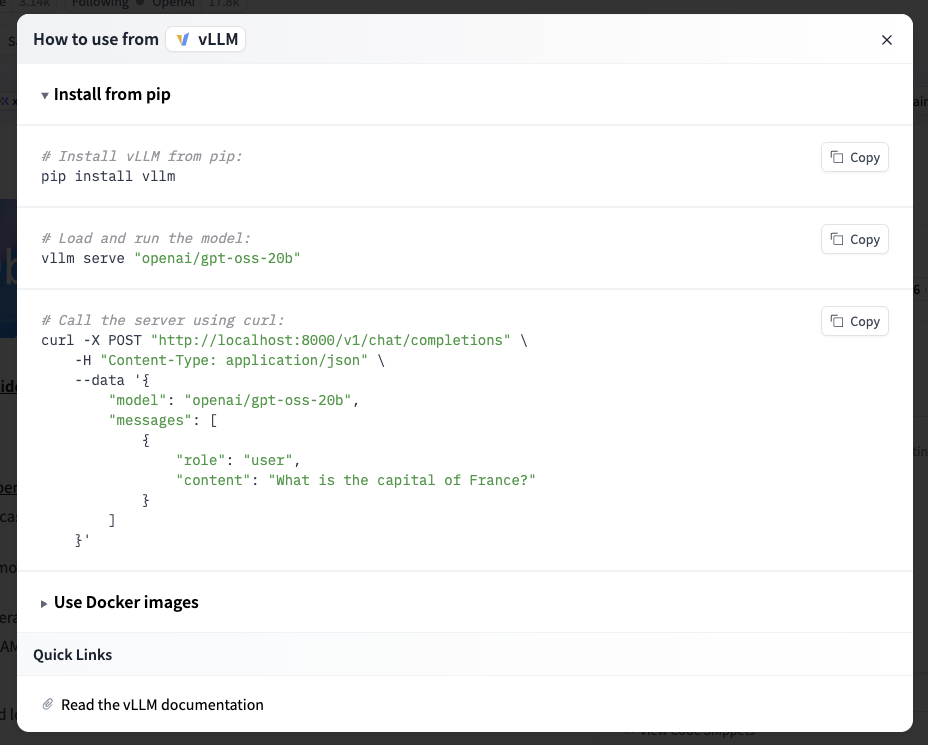
- اختر التطبيق المحلي من قائمة “Use this model” المنسدلة في صفحة النموذج.

- انسخ الأمر المقدم وشغّله في الطرفية.
التطبيقات المحلية المدعومة
يُدرج التطبيق المحلي المدعوم في إعدادات التطبيقات المحلية.
في صفحة النموذج، لا يظهر تطبيق في القائمة المنسدلة “استخدم هذا النموذج” إلا إذا كان النموذج متوافقًا معه (على سبيل المثال، نموذج GGUF لـ llama.cpp أو Ollama).
التطبيقات التالية متاحة حاليًا على Hub:
| تطبيق | الموقع الإلكتروني | النماذج المتوافقة |
|---|---|---|
 Llama | llama.app | GGUF |
 llama.cpp | github.com/ggml-org/llama.cpp | GGUF |
 LM Studio | lmstudio.ai | GGUF، MLX |
 يناير | jan.ai | GGUF |
 الدردشة الذرّية | atomic.chat | GGUF، MLX |
 Unsloth Desktop | unsloth.ai/docs | GGUF، نماذج Unsloth |
 Ollama | ollama.com | GGUF |
 vLLM | docs.vllm.ai | نماذج توليد النص، ونماذج النص والصورة إلى نص من Transformers وGGUF وAWQ وGPTQ |
 SGLang | docs.sglang.io | نماذج توليد النص ونماذج النص والصورة إلى النص في Transformers، AWQ، GPTQ |
 MLX LM | github.com/ml-explore/mlx-lm | نماذج توليد النص في MLX |
 شغّال نماذج Docker | docs.docker.com/ai/model-runner | نماذج متوافقة مع GGUF وvLLM |
 ليموناد | lemonade-server.ai | GGUF، نماذج AMD Ryzen AI |
 Pi | github.com/earendil-works/pi | نماذج الدردشة GGUF وMLX مع استدعاء الأدوات |
 وكيل Hermes | hermes-agent.nousresearch.com | نماذج الدردشة GGUF وMLX مع استدعاء الأدوات |
 OpenClaw | github.com/openclaw/openclaw | نماذج الدردشة GGUF وMLX مع استدعاء الأدوات |
 Draw Things | drawthings.ai | نماذج النص إلى صورة في Diffusers وLoRAs |
 DiffusionBee | diffusionbee.com | نماذج Diffusers لتوليد الصور من النص |
 JoyFusion | joyfusion.app | نماذج تحويل النص إلى صورة في Core ML الموسومة بـjoyfusion |
👨💻 لاستخدام هذه التطبيقات المحلية، انسخ المقاطع من بطاقة النموذج كما هو موضح أعلاه.
👷 إذا كنت تبني تطبيقًا محليًا، يمكنك التعرف على كيفية التكامل مع Hub في هذا الدليل.
Llama
Llama هو تطبيق أصلي لنظامَي macOS وWindows لتشغيل نماذج GGUF محليًا.
المزايا:
- تطبيق أصلي خفيف الوزن يعمل على شريط القائمة أو شريط المهام
- تثبيت بنقرة واحدة لنماذج GGUF من Hub
- دردشة محلية وخاصة مع النماذج المثبتة
- احصل على نماذج موصى بها لجهازك
- التكامل بسهولة مع وكلاء مثل Pi وHermes وOpenClaw
للاستفادة من Llama، انتقل إلى بطاقة النموذج لنموذج GGUF وانقر على “استخدم هذا النموذج”. سيفتح Llama ويوجهك خلال خطوات تثبيت النموذج.
يتوفر Llama حاليًا لكل من macOS و Windows.
Llama.cpp
Llama.cpp هي مكتبة عالية الأداء بلغة C/C++ لتشغيل نماذج اللغة الكبيرة محليًا مع استدلال مُحسَّن عبر مجموعة متنوعة من الأجهزة، بما في ذلك وحدات المعالجة المركزية، وCUDA، وMetal.
المزايا:
- أداء فائق السرعة للنماذج المعتمدة على المعالج المركزي على عائلات متعددة من المعالجات المركزية
- استهلاك منخفض للموارد
- خيارات متعددة للواجهات (سطر الأوامر، خادم متوافق مع OpenAI مع واجهة ويب)
- مُحسَّن من حيث العتاد للمعالجات المركزية ووحدات معالجة الرسوميات
لاستخدام Llama.cpp، انتقل إلى بطاقة النموذج وانقر على “Use this model” وانسخ الأمر. يغطي هذا المقطع تثبيت llama.cpp (سكربت التثبيت على macOS وLinux، وWinGet على Windows، أو البناء من المصدر) وتشغيل النموذج:
# Install llama.cpp (macOS, Linux):
curl -LsSf https://llama.app/install.sh | sh

# Start a local OpenAI-compatible server with a web UI:
llama serve -hf unsloth/gpt-oss-20b-GGUF:Q4_K_M

# Or run inference directly in the terminal:
llama cli -hf unsloth/gpt-oss-20b-GGUF:Q4_K_M
اقرأ صفحة llama.cpp + HF المخصصة لدينا.
LM Studio
اقرأ صفحة مستند LM Studio المخصصة لدينا
LM Studio هو تطبيق سطح مكتب يوفر طريقة سهلة لتنزيل نماذج LLM المحلية وتشغيلها والتجربة عليها.
المزايا:
- واجهة رسومية بديهية
- متصفح النماذج المدمج
- أدوات المطوِّرين وواجهات برمجة التطبيقات
- مجاني للاستخدام الشخصي والتجاري
انتقل إلى بطاقة النموذج لنموذج من نوع GGUF أو MLX وانقر على “Use this model”. سيُفتح LM Studio ويمكنك بدء المحادثة عبر الواجهة.
يناير
Jan هو بديل مفتوح المصدر لـ ChatGPT يعمل بالكامل دون اتصال بالإنترنت ويوفر واجهة سهلة الاستخدام.
المزايا:
- واجهة مستخدم سهلة الاستخدام
- الدردشة مع المستندات والملفات
- خادم واجهة برمجة تطبيقات متوافق مع OpenAI، مما يتيح لك تشغيل النماذج واستخدامها من تطبيقات أخرى
للاستخدام، انتقل إلى بطاقة النموذج لنموذج GGUF وانقر على “استخدم هذا النموذج”. سيفتح Jan ويمكنك بدء المحادثة من خلال الواجهة.
الدردشة الذرّية
Atomic Chat هو تطبيق محادثة سطح مكتب لتشغيل النماذج المحلية.
المزايا:
- واجهة دردشة رسومية
- يدعم كلا من نماذج GGUF وMLX
للاستفادة من Atomic Chat، انتقل إلى بطاقة النموذج الخاصة بنموذج GGUF أو MLX وانقر على “Use this model”. سيفتح Atomic Chat مع جاهزية النموذج للتنزيل.
Unsloth سطح المكتب
Unsloth Desktop هو تطبيق سطح مكتب من Unsloth لتشغيل النماذج المحلية.
المزايا:
- الواجهة الرسومية
- يعمل مع نماذج GGUF والنماذج من منظومة Unsloth
للاستفادة من Unsloth Desktop، انتقل إلى بطاقة النموذج لنموذج GGUF أو Unsloth وانقر على «استخدام هذا النموذج». سيفتح Unsloth Desktop النموذج، بما في ذلك ملف GGUF الذي اخترته إذا كنت قد اخترته من ملفات النموذج.
Ollama
Ollama هو تطبيق يتيح لك تشغيل نماذج اللغة الكبيرة محليًا على جهازك من خلال واجهة سطر أوامر بسيطة. وهو متاح لنماذج GGUF.
المزايا:
- تثبيت وإعداد بسيطان
- التكامل المباشر مع Hugging Face Hub
للاستفادة من Ollama، انتقل إلى بطاقة النموذج وانقر على “Use this model” ثم انسخ الأمر.
ollama run hf.co/unsloth/gpt-oss-20b-GGUF:Q4_K_M
vLLM
vLLM هو محرك استنتاج وتقديم عالي الإنتاجية لنماذج اللغة الكبيرة، مع خادم واجهة برمجية متوافقة مع OpenAI.
المزايا:
- إنتاجية عالية، مُحسّنة للوحدات المعالجة الرسومية
- يدعم نماذج Transformers وGGUF والنماذج المُكمّاة (AWQ، GPTQ)
- خادم واجهة برمجة تطبيقات متوافق مع OpenAI
يتوفر vLLM لنماذج توليد النص ونماذج النص والصورة إلى النص. انتقل إلى بطاقة النموذج، وانقر على “استخدم هذا النموذج” وانسخ الأوامر:
# Install vLLM from pip:
pip install vllm

# Start the vLLM server:
vllm serve "openai/gpt-oss-20b"

# Call the server using curl (OpenAI-compatible API):
curl -X POST "http://localhost:8000/v1/chat/completions" \
	-H "Content-Type: application/json" \
	--data '{
		"model": "openai/gpt-oss-20b",
		"messages": [{"role": "user", "content": "What is the capital of France?"}]
	}'
يُظهر المقطع أيضاً كيفية تشغيل النموذج باستخدام Docker Model Runner.
SGLang
SGLang هو إطار عمل سريع لتقديم نماذج اللغة الكبيرة ونماذج اللغة والرؤية.
المزايا:
- الاستضافة عالية الأداء على وحدات معالجة الرسوميات
- يدعم نماذج Transformers والنماذج المُكمّاة (AWQ، GPTQ)
- خادم واجهة برمجة تطبيقات متوافق مع OpenAI
يتوفر SGLang لنماذج توليد النص ونماذج النص والصورة إلى النص. انتقل إلى بطاقة النموذج، وانقر على “Use this model” وانسخ الأوامر:
# Install SGLang from pip:
pip install sglang

# Start the SGLang server:
python3 -m sglang.launch_server \
    --model-path "openai/gpt-oss-20b" \
    --host 0.0.0.0 \
    --port 30000
يعرض الخادم واجهة برمجة تطبيقات متوافقة مع OpenAI على المنفذ 30000. كما يتضمن المقطع أمر Docker يستخدم صورة lmsysorg/sglang.
MLX LM
يعمل MLX LM على تشغيل نماذج اللغة الكبيرة (LLMs) على معالجات Apple باستخدام إطار عمل Apple الخاص بـ MLX.
المزايا:
- مُحسَّن لأشباه رقائق Apple
- الدردشة التفاعلية وتوليد النص من سطر الأوامر
- خادم متوافق مع OpenAI
يتوفر MLX LM لنماذج توليد النصوص في MLX. انتقل إلى بطاقة النموذج، وانقر على “استخدم هذا النموذج” وانسخ الأوامر:
# Install MLX LM
uv tool install mlx-lm

# Interactive chat REPL
mlx_lm.chat --model "mlx-community/Qwen3-4B-4bit"

# Or start an OpenAI-compatible server
mlx_lm.server --model "mlx-community/Qwen3-4B-4bit"
Docker Model Runner
يتيح لك Docker Model Runner سحب النماذج وتشغيلها باستخدام واجهة سطر أوامر Docker.
المزايا:
- يستخدم أدوات Docker المألوفة
- يدعم نماذج GGUF والنماذج المتوافقة مع vLLM
انتقل إلى بطاقة النموذج، وانقر على “Use this model” وانسخ الأمر:
docker model run hf.co/unsloth/gpt-oss-20b-GGUF:Q4_K_M
Lemonade
Lemonade هو خادم LLM محلي، مُحسّن للأجهزة من AMD.
المزايا:
- يدعم نماذج GGUF
- تشغيل النماذج المصممة لوحات AMD Ryzen AI NPU (النماذج الموسومة بـ
ryzenai-npuأوryzenai-hybrid)
بعد تنزيل Lemonade، انتقل إلى بطاقة النموذج، وانقر على “Use this model” وانسخ الأوامر:
# Pull the model
lemonade pull unsloth/gpt-oss-20b-GGUF:Q4_K_M

# Run and chat with the model
lemonade run user.gpt-oss-20b-GGUF-Q4_K_M

# List all available models
lemonade list
Pi
Pi هو وكيل برمجي يعمل في الطرفية الخاصة بك.
يتوفر Pi لنماذج الدردشة بصيغتي GGUF وMLX التي يدعم قالب الدردشة الخاص بها استدعاء الأدوات. يبدأ المقطع أولاً خادمًا محليًا متوافقًا مع OpenAI (llama serve لنماذج GGUF، وmlx_lm.server لنماذج MLX)، ثم يهيّئ Pi لاستخدامه:
# Start a local OpenAI-compatible server:
llama serve -hf unsloth/gpt-oss-20b-GGUF:Q4_K_M

# Install Pi:
npm install -g @earendil-works/pi-coding-agent

# start Pi in your project directory:
pi

# configure Pi to use your llama server:
/login llama.cpp
وكيل Hermes
Hermes Agent هو وكيل ذكاء اصطناعي من تطوير Nous Research يمكن تشغيله مع نماذج محلية.
يتوفر Hermes Agent لنماذج الدردشة بصيغتي GGUF و MLX التي يدعم قالب الدردشة الخاص بها استدعاء الأدوات. يبدأ المقطع أولاً خادمًا محليًا متوافقًا مع OpenAI (llama serve لنماذج GGUF، وmlx_lm.server لنماذج MLX)، ثم يهيّئ Hermes Agent لاستخدامه:
# Start a local OpenAI-compatible server:
llama serve -hf unsloth/gpt-oss-20b-GGUF:Q4_K_M

# Install Hermes:
curl -fsSL https://hermes-agent.nousresearch.com/install.sh | bash
hermes setup

# Point Hermes at the local server:
hermes config set model.provider custom
hermes config set model.base_url http://127.0.0.1:8080/v1
hermes config set model.default unsloth/gpt-oss-20b-GGUF:Q4_K_M

# Run Hermes
hermes
OpenClaw
OpenClaw هو وكيل ذكاء اصطناعي شخصي مفتوح المصدر يمكن تشغيله مع نماذج محلية.
يتوفر OpenClaw لنماذج الدردشة بصيغتي GGUF وMLX التي يدعم قالب الدردشة الخاص بها استدعاء الأدوات. يبدأ المقطع أولاً خادمًا محليًا متوافقًا مع OpenAI (llama serve لنماذج GGUF، وmlx_lm.server لنماذج MLX)، ثم يهيّئ OpenClaw لاستخدامه:
# Start a local OpenAI-compatible server:
llama serve -hf unsloth/gpt-oss-20b-GGUF:Q4_K_M

# Install OpenClaw:
npm install -g openclaw@latest

# Register the local server and set it as the default model:
openclaw onboard --non-interactive --mode local \
  --auth-choice custom-api-key \
  --custom-base-url http://127.0.0.1:8080/v1 \
  --custom-model-id "unsloth/gpt-oss-20b-GGUF:Q4_K_M" \
  --custom-provider-id llama-cpp \
  --custom-compatibility openai \
  --custom-text-input \
  --accept-risk \
  --skip-health

# Run OpenClaw
openclaw agent --local --agent main --message "Hello from Hugging Face"
Draw Things
Draw Things هو تطبيق لتوليد الصور محليًا على أجهزة Apple.
المزايا:
- تشغيل نماذج النص إلى صورة بالكامل على الجهاز
- يمكن استيراد كلا من النماذج الأساسية وLoRAs
للاستفادة من Draw Things، انتقل إلى بطاقة النموذج لنموذج نص إلى صورة من Diffusers أو LoRA وانقر على “Use this model”. سيفتح Draw Things ويستورد النموذج.
يتوفر Draw Things على نظام macOS فقط.
DiffusionBee
DiffusionBee هو تطبيق سطح مكتب لتوليد الصور محليًا باستخدام نماذج Stable Diffusion.
المزايا:
- واجهة رسومية بسيطة
- لا يتطلب أي إعداد أو سطر أوامر
للاستفادة من DiffusionBee، انتقل إلى بطاقة النموذج لنموذج نص إلى صورة من Diffusers وانقر على “استخدم هذا النموذج”. سيفتح DiffusionBee ويستورد النموذج.
يتوفر DiffusionBee على نظام macOS فقط.
JoyFusion
JoyFusion هو تطبيق لتوليد الصور محليًا باستخدام نماذج Core ML على أجهزة Apple.
للاستفادة من JoyFusion، انتقل إلى بطاقة النموذج لنموذج Core ML لتوليد الصور من النص الذي يحمل وسم joyfusion ثم انقر على “Use this model”. سيفتح JoyFusion ويستورد النموذج.
Update on GitHubيتوفر JoyFusion على نظام macOS فقط.